
Perplexity 的回答里几乎总能看到编号来源,这让它成为最容易观察引用情况的产品之一。但也正因为来源可见,很多团队把它当成一个可以优化的“引用率指标”,忽略了官方文档里写得很清楚的一件事:这里有两个不同的抓取对象,行为并不一样。
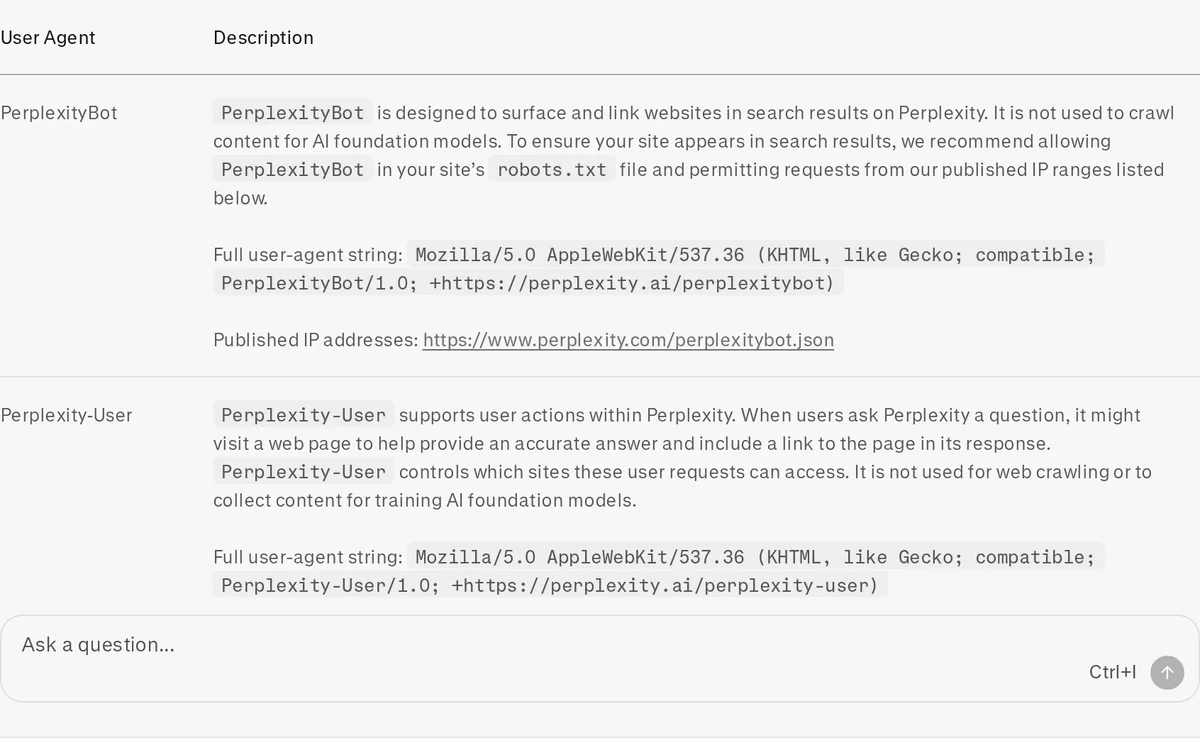
PerplexityBot 与 Perplexity-User 是两回事
按官方文档,PerplexityBot “is designed to surface and link websites in search results on Perplexity. It is not used to crawl content for AI foundation models.” 文档同时建议站点在 robots.txt 里放行它,并按官方公布的 IP 段校验来源。这一段的意思是:PerplexityBot 更接近一个搜索爬虫,它负责把页面收进 Perplexity 可检索的语料里。
另一个是 Perplexity-User。文档说明它“supports user actions within Perplexity. When users ask Perplexity a question, it might visit a web page to help provide an accurate answer and include a link to the page in its response.” 关键在于最后一句:“Since a user requested the fetch, this fetcher generally ignores robots.txt rules.”
这句话带来的结论和很多人的直觉相反:robots.txt 不能让你的页面完全不出现在 Perplexity 的回答里。 用户点名提问时触发的单页抓取,本身是按用户请求执行的。要真正阻断这类访问,只能在服务端做访问控制,但那同时也会影响正常访客。所以第一步不是急着改 robots.txt,而是先想清楚你要的是什么:是不希望内容被训练(那是另一个 bot 的问题),还是不希望被检索展示(那是搜索侧设置),还是两者都要处理。
引用是结果,不是可以单独提高的指标
“品牌被提到”和“官网被引用”是两件不同的事。回答里出现品牌名,可能来自第三方报道、目录平台或者论坛;只有附上了你站点的链接,才算你的页面被引用。这两类情况在记录时应该分开计数,否则报告会把别人的功劳算在自己头上。
把两者混在一起还有一个副作用:为了解决“没被引用”,最容易想到的动作是加大发稿量。但如果官网本身没有可被引用的具体事实,新的外部内容也只是把同一句模糊的介绍换个地方再说一遍。
来源建设:先让被引用的那一页站得住
可被引用的页面通常满足三个特征。第一,它有能力单独回答问题:把问题、答案、适用条件放在同一页同一节里,不需要读者再跳到别处才能理解。第二,它写的是别处没有的事实,例如自有测试口径下的参数范围、具体的安装与维护条件、真实项目的交付边界。第三,它的核心事实能被别的公开来源印证,包括目录平台、行业媒体、企业信息平台上的名称与业务描述不冲突。
这三条顺序不能颠倒。很多项目先做第三条,在外部平台发一批内容,而官网的第一条和第二条还是空的,结果引用链接指向的还是别人家的页面。source_url 和采集口径可以这样记录:每条来源链接记下 URL、抓取时间、页面上支持该结论的原句,以及该页面的更新日期(如果页面显示)。
一次可执行的来源检查
下面是一组教学样例问题,用来演示检查流程,不是任何平台的真实回答,也不代表客户数据。
- 教学样例:问一个只有你们官网写过答案的技术问题,看回答是否引用官网,还是引用了转载页面。
- 教学样例:问一个参数对比问题,看回答里的单位与适用条件是否与官网一致。
- 教学样例:问一个行业通用问题,看回答引用的第三方来源里,有没有出现品牌写法不一致的情况。
- 教学样例:用一个更口语的长问题追问一次,看第二轮回答的来源是否变化。
记录字段建议固定为:问题原文、时间、是否登录、语言、完整回答、可见来源链接、来源页面是否支持该结论、偏差描述。少一个字段,两次记录就没有办法对比。
记录来源时最容易忽略的两列
来源清单里通常有 URL、出现时间、被引用的表述,容易漏掉的是“这一页由谁维护”。被引用的页面如果属于第三方目录、论坛或转载站,你只能请求更正,无法直接改;属于自家域名下的页面,才在自己手里。把维护方写进表里,处理路径就自动分成两条。
另一列值得加的是“这条来源在回答里起什么作用”:是支持了某个结论,还是仅仅被提到。同样是链接,作用可能完全不同。分类之后再看总量,会发现真正起支持作用的往往只是少数几页,而这几页恰好是最值得投入更新的对象。
还有一件与日志有关的事。Perplexity 官方文档说明它会从公布的 IP 段发起请求,并建议站点在 WAF 上同时按 User-Agent 与 IP 段放行。如果日志里出现了自称 PerplexityBot、但来源 IP 不在官方列表里的请求,那不是它的抓取,不能据此判断平台行为。看日志之前先做这一步校验,能省掉很多误判。
不能声称的部分
Perplexity 官方文档没有公开它的检索范围、来源排序方式,也没有说明它为什么在某次回答里选择某一页。你能做的只有观察:同一个问题在一段时间内是否稳定引用同一批来源,来源列表里有没有你的页面,以及被引用页面的内容有没有被准确复述。把这三件事记录成事实,比编一个“引用机制”要可靠得多。
Google 侧的资格条件写在AI Overviews 与 AI Mode 那篇里;如果你在不同平台看到互相矛盾的答案,先按跨平台差异的三类归因做分类,再决定改哪里。光算在GEO 服务中把来源检查、事实一致性与回答快照放在同一个验收口径下,具体执行范围按项目确定,不承诺任何平台必然引用。
如果只看两篇,建议先看:谷歌AIO(AI概览)引用来源分析:什么样的站更吃香。
参考来源
- Perplexity Crawlers — 支持“PerplexityBot 用于搜索展示、不用于训练”。