
把同一个问题分别丢给几个全球主流助手,几乎一定会得到不同答案。有的引用官网,有的引用第三方平台,有的只给了泛泛的行业描述。这时候最容易出现的动作是立刻去改内容。但在动手之前,先分清差异属于哪一类,能省掉大量无效工作。
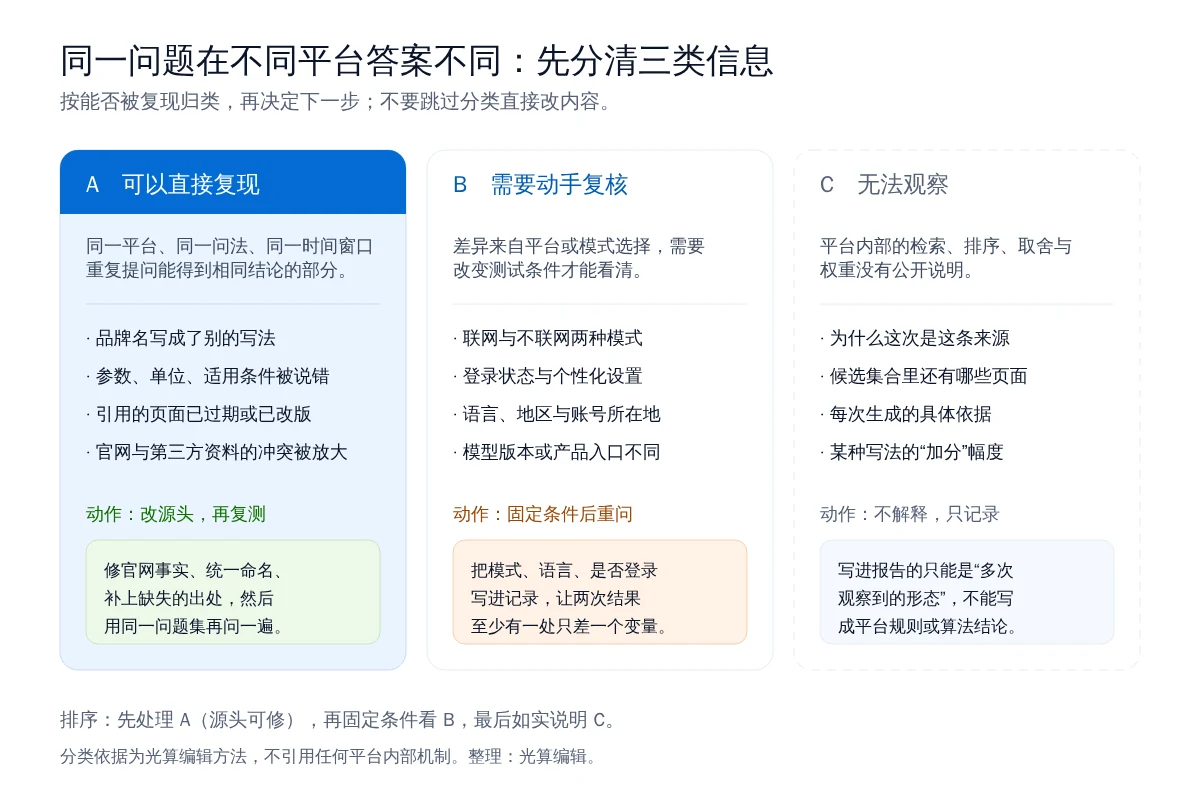
差异的三种来源
第一类是可以直接复现的差异。 同一平台、同一问法、同一时间窗口,重复提问能得到相同结论的部分。这类差异通常指向内容本身:品牌写成了别的写法、参数缺条件、回答引用的页面已经过期、官网与第三方资料互相矛盾。它的特点是稳定,正因为稳定,才可以被修好并复测。
第二类是改变了条件才能看清的差异。 差异来自平台或模式的选择,而不是内容。常见变量有联网与不联网、是否登录、界面语言与账号地区、产品入口不同、模型版本不同。这类差异不会因为你改了官网而消失,只能通过固定条件重问来确认。
第三类是无法观察的部分。 平台内部的检索范围、候选页面、排序与取舍过程都没有公开说明。为什么这次是这条来源、候选集合里还有哪些页面、每次生成的依据是什么,外部看不到。这一类只能记录结果形态,不能写成规则。
为什么不能跳过分类直接改内容
如果差异其实属于第二类,改内容不会有任何变化,团队会陷入“改了没效果、继续加内容”的循环。如果差异属于第三类,把一次观察写成“平台偏好某种写法”,会让后续的资源投入建立在一个不存在的机制上。分类这一步花的时间很少,省下的返工很多。
更实际的一点是:三类差异的处理成本完全不同。第一类的源头在自己手里,可以立刻动手;第二类需要重做测试设计;第三类只能如实写入报告的边界说明。
先把问题集本身固定下来
跨平台比较的前提是问题本身不变。问题集里至少要有三类:品牌类(这家公司做什么)、选型类(这种工况下怎么比较参数)、争议类(某项说法的适用条件)。三类问题的差异来源不同,混在一起统计会让结论失真。
每类问题建议配一句追问,用来观察第二轮回答是否与第一轮一致。不一致本身就是一条值得记录的观察结果,但它属于哪一类差异,需要重复验证之后再判断,不要在一次会话里就下结论。
归因顺序
- 固定条件重问两到三次,确认差异是否稳定。若每次都不一样,先归到第二类,检查测试条件是否写清。
- 差异稳定时,把回答里的品牌写法、参数、业务描述逐条与确认过的事实清单对照。
- 对照结果分成三类:可以直接改的源头错误、需要内部确认的口径、缺少证据无法判断的项。
- 只处理前两类,第三类进入待办而不是硬写一个结论。
- 处理完成后,在同一条件下重问,记录变化;条件有变的那次单独标注。
用一个具体例子走一遍
教学样例(非真实客户数据):假设在某平台问“某类设备在潮湿环境怎么选”,回答里写了一个参数值,但这个值和官网不同。处理方式是:先确认参数的真实口径与单位,判断是官网写错了、还是回答把不同型号的参数混在了一起;再检查这个数字在其他公开页面上是否也出现过。如果答案来自某个转载页,就处理那份转载资料;如果答案只是把两个型号混在一起,那是回答层面的问题,官网能做的是把型号与适用工况写得更不易混淆。
随后重问一次。如果这次参数对了,属于第一类差异处理成功;如果参数还错,而且每次错法都不一样,就应该把它归到第二类或第三类,在报告里说明当前无法通过内容修正来解决。
同一平台内部也会不一致
跨平台比较时容易忽略一件事:同一个平台换一个入口,答案也可能不同。网页版与桌面应用的检索范围、界面语言、账号地区的处理方式未必一致。如果只在一个入口取样,得到的“平台特征”其实还有可能是入口特征。记录时把入口类型写成独立字段,这个问题在下一次复测时就会自己浮现出来。
报告里怎么写
可写的结论有:某个时间、某种条件下,某个问题在哪些平台被提及、提到的事实是否准确、可见来源指向哪里。不可写的是平台偏好、权重、收录规则与推荐机制。把观察、改动、结果三部分分开陈述,报告读起来反而更有分量,因为它没有替平台编一套不存在的说明书。
模式差异属于第二类里最常见的一种,记录方式见联网与不联网模式的对照方法;如果差异最后落在资料本身对不齐,品牌资料一致性核对给的是可执行的表格做法。光算的GEO 服务把这些归类规则写进复测与报告口径,覆盖哪些平台、采样多少次按项目约定,无法归因的部分会单独列出,不包装成平台机制。
要把这部分落到实际项目里,另外几篇值得先读:国内GEO怎么验收:用固定问题集记录品牌提及、引用来源和事实偏差、谷歌AIO(AI概览)引用来源分析:什么样的站更吃香。
参考来源
- Perplexity Crawlers — 支持“用户触发的抓取通常忽略 robots.txt”。
- Overview of OpenAI Crawlers — 支持“用户触发的访问不一定受 robots.txt 约束”。
- Enable and use web search — 支持“新版界面没有联网开关”。
- Generative AI performance report (Search) - Search Console Help — 支持“报表覆盖范围会随产品变化”。