
服务器日志里突然出现一串陌生的 User-Agent:GPTBot、ClaudeBot、PerplexityBot、Google-Extended。多数人的第一反应是「要不要禁掉」。这个问题没有统一答案,因为每个爬虫在替不同的系统做事:有的给搜索索引取页面,有的给模型取训练语料,还有的只是某个用户在当次提问时触发了抓取。三类角色的取舍方向完全不同。
先按用途分类,再谈放行还是限制
Google 在自己的爬虫总览里把访问者分成三类:常见爬虫(为 Google 产品自动抓取,自动抓取时始终遵守 robots.txt 规则)、特殊场景爬虫(与站点之间存在约定的特定产品),以及用户触发的抓取器(由终端用户的操作触发,例如站点验证工具)。这个分类方式可以直接借用到 AI 语境:判断一个爬虫该不该放过,先看它是自动来的,还是被某个人当场叫来的。
把这套分类套到各家平台上,大致是这样:
- 搜索索引类:Googlebot、OAI-SearchBot、Claude-SearchBot、PerplexityBot、bingbot。它们抓取的结果决定你的页面能不能出现在对应产品的搜索结果或答案的来源位置。
- 模型训练类:Google-Extended、GPTBot、ClaudeBot,以及 Bing 体系之外常见的 CCBot 等第三方语料爬虫。它们抓取的内容用于训练或改进模型,与「你的页面今天有没有被展示」是两件事。
- 用户触发类:ChatGPT-User、Claude-User、Perplexity-User。用户问了问题,系统才会去读某一个页面。
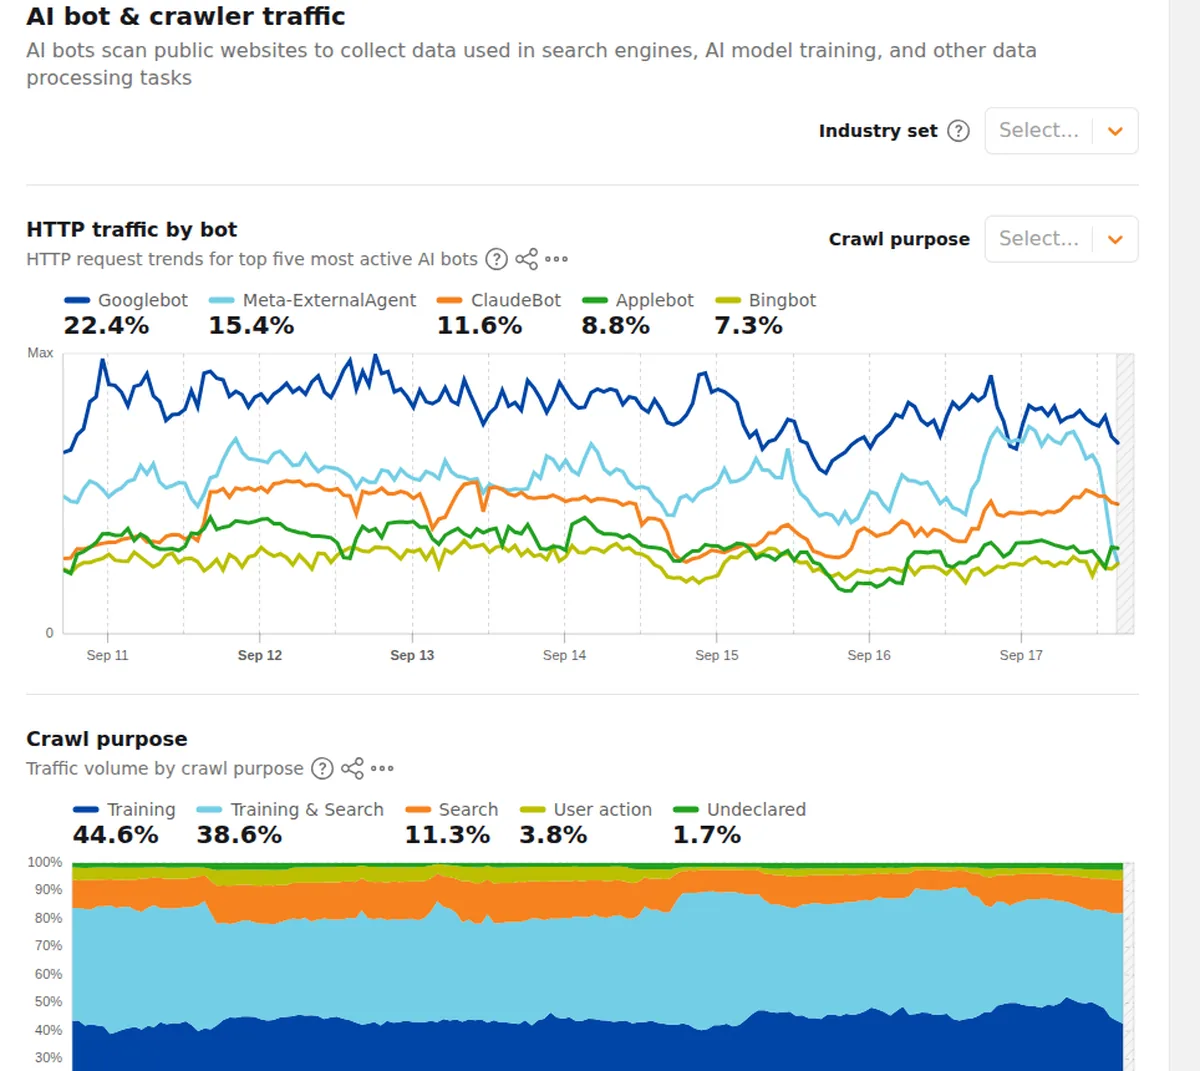
在真实流量里,这三种用途确实是可以分开统计的。Cloudflare Radar 的 AI Insights 看板把 AI 机器人的 HTTP 请求按用途拆成训练、训练与搜索兼用、搜索、用户触发等类别,也会给出主要机器人的请求占比。看这份公开数据时要注意口径:它统计的是整个互联网的总体情况,不是你这家站点的日志,而且时间范围只覆盖看板上的滚动窗口。
Google-Extended 不是 Googlebot 的替身
最常见的误解是把 Google-Extended 当成「谷歌 AI 爬虫的开关」。Google 的爬虫文档写得很直接:Google-Extended 没有独立的 HTTP 请求 User-Agent 字符串,抓取由现有的 Google 抓取标识完成,robots.txt 里的 user-agent token 只起控制作用。它管的是站点内容能不能用于训练后续的 Gemini 模型、能不能给 Gemini 应用和 Vertex AI 提供 grounding 内容。
同一份文档还补了一句对做业务决策很关键的话:Google-Extended 不影响站点在 Google 搜索中的收录,也不是 Google 搜索的排名信号。换句话说,想控制搜索侧怎么用你的内容,要用针对 Googlebot 的 robots.txt 指令,或者 nosnippet、data-nosnippet、max-snippet、noindex 这类预览与索引控制;Google-Extended 管不到这些。
还有一条实用判据:如果一个爬虫的官方文档里找不到它的用途说明,就不要把「它抓了你的页面」解释成任何一种具体后果。抓取日志能证明的只是「有人来取过这份内容」,取去做什么、之后会不会被用上,需要回到对应平台的文档里找依据,找不到就如实标注为未知。
其他平台的官方描述,逐条核对
OpenAI 的爬虫文档把两个 robots.txt token 的作用分开说明:允许 OAI-SearchBot 是为了出现在搜索功能里,禁止 GPTBot 表示内容不希望被用于训练基础模型,两个设置互相独立;站点的 robots.txt 更新后,搜索侧大约需要 24 小时调整。文档同时说明,被排除在 OAI-SearchBot 之外,站点不会出现在 ChatGPT 的搜索回答里,但仍可能作为导航链接出现。至于 ChatGPT-User,OpenAI 明确写着它不是自动抓取工具,因为动作由用户发起,robots.txt 规则可能不适用。
Anthropic 现在把爬虫拆成三个:ClaudeBot 收集可能用于训练的内容,Claude-User 在用户提问时读取页面,Claude-SearchBot 用于改善搜索结果质量。三点都写明各自的 robots.txt token,并说明限制某个 Bot 会影响对应的能力。Anthropic 还表示支持非标准的 Crawl-delay 扩展,并明确提示:通过封 IP 来退出抓取可能不可靠,因为那会妨碍系统读取你的 robots.txt。
Perplexity 的文档把 PerplexityBot 描述为「用于在 Perplexity 的搜索结果中呈现并链接网站」,并写明它不用于抓取训练基础模型的内容;Perplexity-User 则是用户提问时的即时访问,因为请求由用户发起,这个抓取器通常会忽略 robots.txt 规则。
Bing 的爬虫文档列的是 Bingbot、AdIdxBot、BingPreview、MicrosoftPreview、BingVideoPreview 这些身份与各自用途,并为每个列出 User-Agent 字符串样例。文档里没有为 Copilot 单列一个爬虫身份;Copilot 与 Bing 索引之间的关系,在这份爬虫文档里没有展开说明,能确认的只是 Bingbot 负责 Bing 的绝大部分抓取。
在日志里确认身份:能做的和不能做的
User-Agent 字符串可以随便伪造,所以「日志里有 GPTBot 字样」不足以证明对方真的是 GPTBot。可以做的核对有这些:Google 建议同时用请求头 User-Agent、来源 IP 和反向 DNS 主机名三种方式验证;OpenAI、Perplexity、Anthropic 都公布了各自的 IP 段 JSON 或清单,可以配合 UA 一起判断;Bing 提供专门的验证工具,并提醒 UA 可以被伪造。
不能做的部分也要说清楚:这些验证手段只能确认「这次请求来自哪个系统」,无法确认「这次抓取之后会不会被用于回答、会不会被引用」。目前没有任何一家平台公开完整的检索、筛选与引用机制。
抓到了不等于会被引用
最后一条边界值得单独记住。Google 说明,页面要成为 AI Overviews 或 AI Mode 里的支持链接,需要先被索引、并且有资格在 Google 搜索中展示摘要,没有额外的技术要求;但同一份文档也写着,即使页面满足全部要求与最佳实践,也不意味着 Google 一定会抓取、索引或提供它的内容。抓取与索引是必要条件,不是结果承诺。
把这三类角色分清之后,下一个问题才是配置层面的取舍:哪些 token 该允许、哪些该写 Disallow、写了为什么可能不生效。这部分我们在robots.txt 里 AI 爬虫 token 怎么写里逐行拆开讲。如果你的站点正在做海外市场,需要把这些技术前提和内容、信源一起看,可以参考光算的 GEO 服务,具体检查范围按项目情况确定。
同一问题的相邻角度:Cloudflare Firewall Blocking Google Crawler | How to Solve the Indexing Failure、抓取量下滑先看哪儿?用GSC主机状态区分DNS、连接与robots问题。
参考来源
- Overview of Google crawlers and fetchers (user agents) — Google 把访问者分成常见爬虫、特殊场景爬虫和用户触发抓取器三类,自动抓取始终遵守 robots.txt。
- Google common crawlers — Google-Extended 没有独立的请求 User-Agent,只作为 robots.txt 控制 token 使用。
- Overview of OpenAI Crawlers — OpenAI 用 OAI-SearchBot 和 GPTBot 两个独立的 robots.txt token 分别管理搜索展示与训练用途。
- Does Anthropic crawl data from the web, and how can site owners block the crawler? — Anthropic 把爬虫拆成 ClaudeBot(训练)、Claude-User(用户请求)、Claude-SearchBot(搜索质量)三个身份。
- Perplexity Crawlers — PerplexityBot 用于在 Perplexity 搜索结果中呈现并链接网站,不用于训练基础模型。
- Which Crawlers Does Bing Use? - Bing Webmaster Tools — Bingbot 是 Bing 的标准爬虫,文档列出多个爬虫身份与 User-Agent 样例。