
AI Overviews 和 AI Mode 会在回答旁边挂出支持链接。企业最常问的一个问题是:要做什么才能被挂上去?这个问题在 Google Search Central 的文档里其实有很直白的答案,难点不在于找到技巧,而在于接受这份答案比想象中更少要求。
篇幅与能否被引用是两件事:更长的内容并不天然更容易被引用,全面才是。篇幅该怎么定,见英文 SEO 文章的篇幅判断。
官方给出的资格链,只有一条
Google 在 “AI features and your website” 这篇文档里写道:“There are no additional requirements to appear in AI Overviews or AI Mode, nor other special optimizations necessary.” 后面又更具体地说明:“To be eligible to be shown as a supporting link in AI Overviews or AI Mode, a page must be indexed and eligible to be shown in Google Search with a snippet, fulfilling the Search technical requirements. There are no additional technical requirements.”
翻译成可执行的检查项就是三步:抓取没有被挡住,页面已经被收录,页面有资格在搜索结果里显示摘要。第三条和摘要控制项有关,如果站点用 nosnippet、data-nosnippet 或 max-snippet 限制了摘要,需要先确认这些设置是不是误伤。
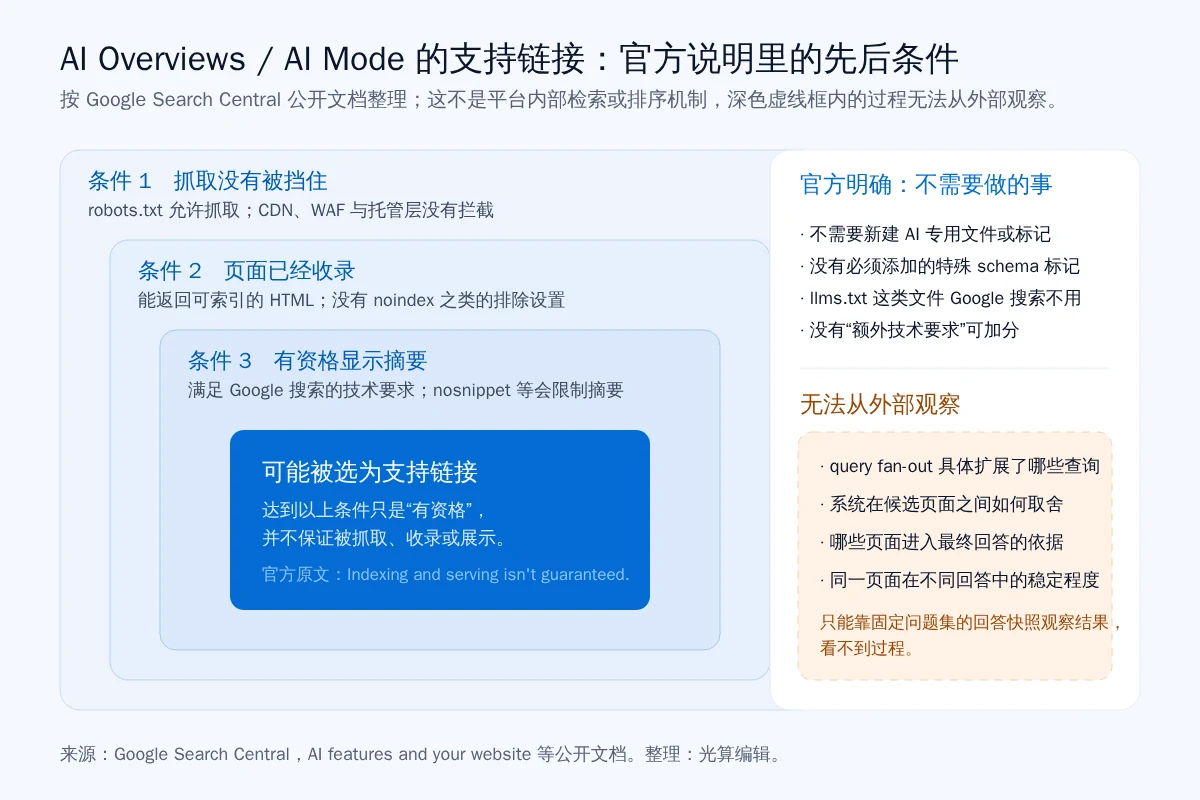
而且达到这三条之后,事情仍然没有保证。官方原文是:“Just because a page meets all requirements, best practices, and complies with the policies, doesn't mean that Google will crawl, index, or serve its content. Indexing and serving isn't guaranteed.” 这句话写得比大多数第三方解读更保守,引用它的时候不要省略后半句。
官方同样明确了不需要做的事
同一份文档接下来写道:“You don't need to create new machine readable files, AI text files, or markup to appear in these features. There's also no special schema.org structured data that you need to add.” 在生成式 AI 优化指南里,Google 继续点名了 llms.txt 这类做法,说明 Google 搜索本身不使用这些文件;结构化数据也“isn't required for generative AI search”。
这意味着两件事。第一,把精力放在新建 AI 专用文件上,收益不会被平台承认,因为公开文档明确说了不使用。第二,结构标记仍然有价值,但价值在于让页面语义清晰、与可见内容一致,而不是作为入选的门票。文档里还有一句话值得记住:“Making sure your structured data matches the visible text on the page”——不匹配的标记,反而制造矛盾。
query fan-out 对页面分工的实际影响
官方描述里有两个技术词。一个是 RAG,也就是检索增强生成,文档解释为 “relying on our core Search ranking systems to retrieve relevant, up-to-date web pages from our Search index”。另一个是 query fan-out,原文是:“Both AI Overviews and AI Mode may use a "query fan-out" technique — issuing multiple related searches across subtopics and data sources — to develop a response.” 优化指南里举过一个例子:用户问怎么处理长满杂草的草坪,fan-out 出来的查询可能包括除草剂选择、不用化学药剂的办法、以及如何预防。
把这段话落到内容规划上,结论很实用:一个“产品总览”页面很难同时回答“怎么选”“有什么限制”“维护成本多少”这一串子问题。更稳的结构是主题页负责讲清产品和适用范围,再用若干独立页面回答单独的子问题,每个页面把条件、单位、适用范围写在答案附近。这样做的目的不是迎合某个算法特征,而是让页面在被单独引用时不会说错话。
先确认自己有没有把门关上
在讨论“为什么没被引用”之前,先排除自己动手关掉的可能性。Search Console 现在有一个 Search generative AI 控件,文档说明它管理站点在 AI Overviews、AI Mode 以及 Discover 生成式特性中的纳入与否。默认值是“包含”,也就是说如果没有人改过,站点是参与的。控件页面同时写清了一个边界:“this control isn't used as a ranking or inclusion signal affecting other parts of Search.”
测量方面,Generative AI performance report 已经全球铺开,文档注明 “As of August 31, 2026, we've rolled out these insights to all websites worldwide.” 这个报表给的是展示次数:“Impressions are how many times links to your site were shown to a user in a generative AI feature on Google Search.” 它按页面、国家、日期和设备分组,不提供查询词,也不提供点击和排名。看这份数据时不要把它当成搜索流量报表的替代品。
看不见的部分要如实标注
官方文档能告诉你的到这里就结束了。fan-out 具体展开了哪些查询、候选页面之间怎么取舍、这一次为什么选了这个来源而不是那个,全部没有公开说明。任何声称掌握了 AI Overviews 引用权重的说法,都不是从公开资料里来的。
能做的替代方案是记录结果形态:固定一批问题、固定语言与地区、固定时间间隔,重复提问并把回答与可见来源存下来,观察同一个页面在不同问题下的出现频率和表述一致程度。这类记录只能支持“多次观察到什么”的结论,不能反推出规则。
把检查写成一张同事也能跑一遍的清单
上面这些条件如果只留在自己脑子里,换一个人接手就会把同样的问题重新问一遍。写成带判定栏的清单更省事:每一项写清检查对象、判定标准、证据放在哪。
- 抓取:robots.txt、CDN 与 WAF 规则里,Googlebot 是否被放行。判定标准是“没有拦截正文页的规则”。
- 收录:用站点查询或 Search Console 的页面报告确认目标页已收录。没被收录的页面谈不上被引用。
- 摘要资格:检查页面是否设置了 nosnippet、data-nosnippet、max-snippet。这三项限制的是摘要,不会加快任何事情的进度。
- 内容一致性:结构化数据与可见文字是否指向同一事实。
- 纳入状态:Search Console 的 Search generative AI 控件是否为默认的“包含”。
- 观察记录:固定问题集、语言、地区与记录字段,保留原始回答。
清单的价值在于把“我以为已经做了”变成“有记录可以查”。每一项都对应一个可以打开、可以留档的对象,而不是一句自我判断。
一个不夸张的落地顺序
先查抓取与收录,再查摘要控制项,然后核对结构化数据与可见文字是否一致。接着把问题集分成主题类与子问题类,检查每一类是否都有对应的公开页面,且答案附近写清了条件与依据。最后,把上面这些检查结论与实际观察到的回答形态分开写进记录。整件事没有捷径,但至少方向是清楚的。
如果你同时要处理 Copilot 那一侧的检索路径,Copilot 与 Bing 生态的可检索事实建设顺序里有对应的顺序;需要按平台分别管理来源时,Perplexity 的两个爬虫与来源建设是同一套思路的另一个例子。光算在GEO 服务里把这些检查和记录做成项目内的固定动作,具体范围按品牌现状确定,不承诺进入任何平台的回答或推荐位。
与这篇属于同一组问题的还有:如何在 Google AI 概览中对您的网站进行排名、Google AI Overviews出现后点击下降:如何排查并改进内容。
参考来源
- AI Features and Your Website — 支持“没有额外要求,也没有特殊优化”。
- Optimizing your website for generative AI features on Google Search — 支持“RAG/grounding 依赖核心搜索排序系统取当前网页”。
- Search generative AI control - Search Console Help — 支持“该控件不影响搜索其他部分的排名或纳入”。
- Generative AI performance report (Search) - Search Console Help — 支持“生成式 AI 性能报表已全球铺开”。