GEO
共 102 篇文章 · 第 5 / 11 页
-
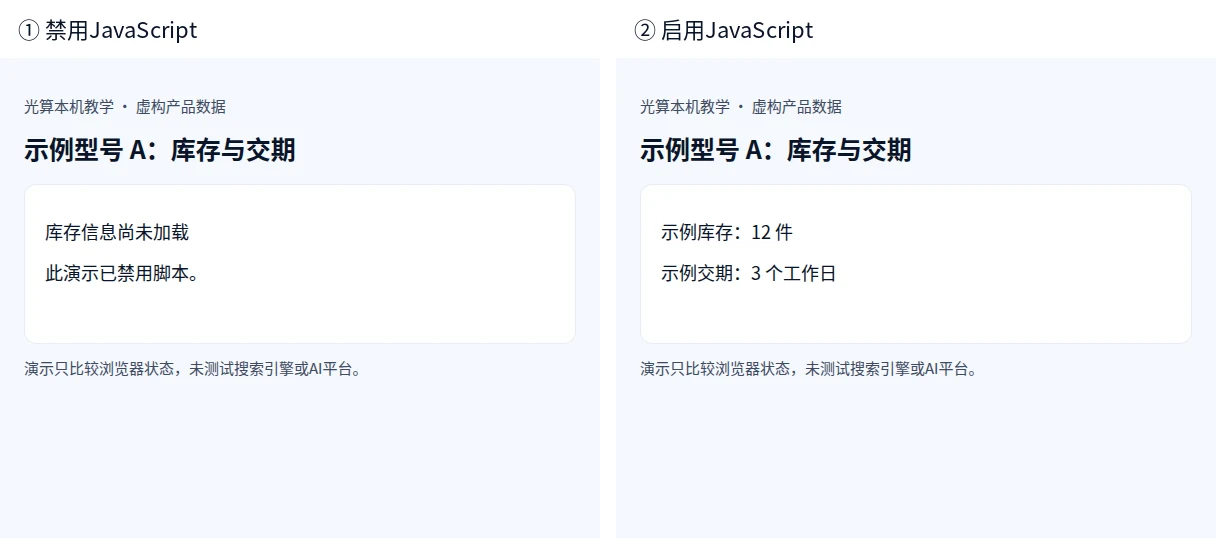
AI爬虫能读JavaScript吗?从HTML、渲染到平台证据逐步查
用真实本机教学截图区分原始响应、无脚本页面和渲染DOM;核Google、Bing公开说明,按用途判断其他机器人,定位接口、路由和内容缺失。
-
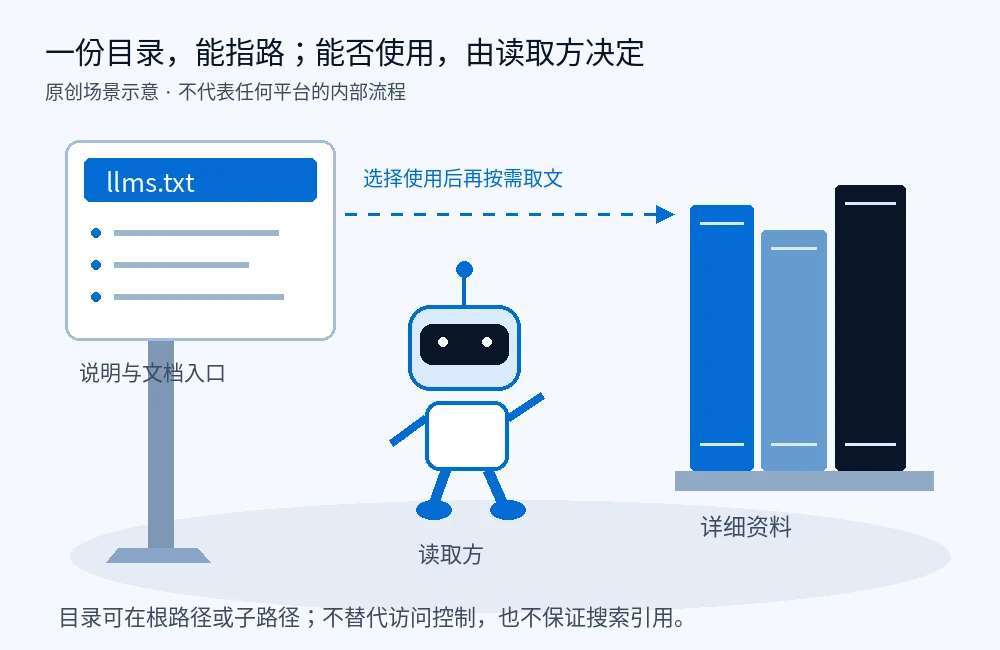
llms.txt到底有没有用?先看读取方,再决定怎么做
区分llms.txt提案、Google搜索和Lighthouse审计;核根路径与子路径、文档平台实现、维护成本与真实读取任务,判断企业官网是否值得做。
-
robots.txt 怎么配:允许还是禁止 AI 抓取,先分清要挡的是哪一类
把搜索索引、模型训练和用户触发抓取三类 token 分开,讲清 Google-Extended 与 Googlebot 的差别、分组与最长路径规则、Crawl-delay 谁支持,并用一份真实 robots.txt 逐行对照。
-
AI 爬虫盘点:GPTBot、Google-Extended、ClaudeBot、PerplexityBot 都在抓什么
按各家官方文档逐个核对主流 AI 爬虫的身份与用途,分清搜索索引抓取、模型训练抓取和用户触发抓取三类角色,并说明日志侧能核对到什么、核对不到什么。
-
模型更新后回答变了:监测口径怎么保持可比
模型或产品更新会影响监测连续性,本篇给出四个必备字段、更新发生时的处理流程、重设基线的判断标准与留档要求。
-
同一问题在不同平台答案不同:先分清三类信息再动手
把跨平台答案差异分成可复现、需动手复核、无法观察三类,给出归因顺序、具体例子与报告里可写不可写的边界。
-
联网与不联网模式:同一问题的回答差异怎么记录
同一问题在两种模式下答案不同,本篇给出只变一个变量的对照方法、固定记录字段,以及两类结果各自能说明什么问题。
-
Grok 与实时信息:时效性内容怎么准备才经得起复查
实时检索会取当前版本,本篇给出页面时间口径(版本、生效日期、适用范围)的写法,以及用响应头自查时效的演示与记录方式。
-
Claude 与深度研究型提问:长文和比较内容怎么写
面对会追问、要依据的研究型提问,长文按判断条件与边界分层组织,比较内容做到同维度同单位同条件,并给出自测方法。
-
Microsoft Copilot 与 Bing 生态:把可检索事实按顺序建设好
Copilot 通过 Bing 取资料,本篇给出从抓取收录到官网事实、再到第三方来源的建设顺序,并说明来源按钮能看到什么、看不到什么。