
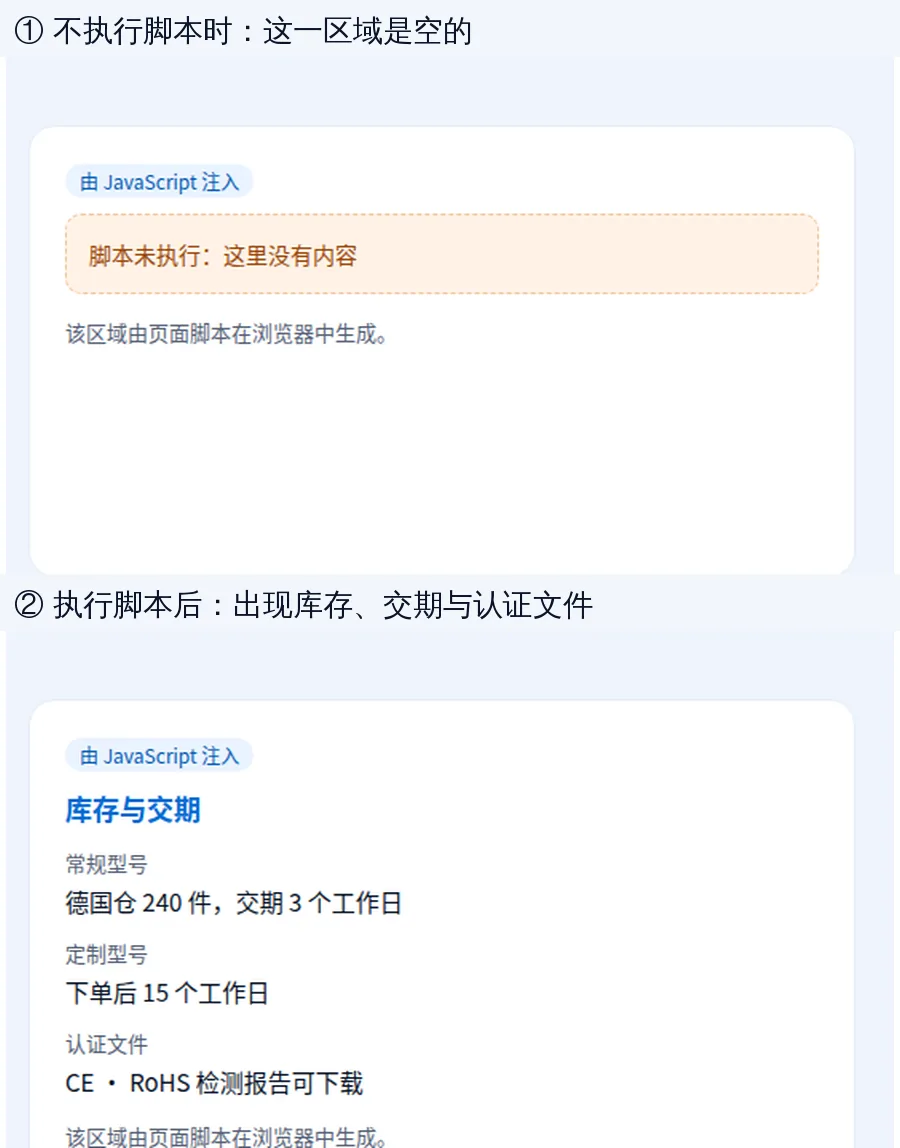
同一份 URL,不同程序打开会看到不一样的东西。一个只把 HTML 取回来就解析的抓取器,看到一个版本;一个执行脚本后才渲染出内容的浏览器,看到另一个版本。做 AI 检索相关的工作时,第一个问题不是「页面好不好看」,而是「关键信息在哪个版本里」。
先把谷歌的公开流程看清楚
谷歌的 JavaScript SEO 文档把处理过程分成三个阶段:抓取、渲染、索引。Googlebot 会把页面同时排进抓取队列和渲染队列;抓取时先读 robots.txt,如果该 URL 被标为不允许,就直接跳过不发请求,页面上、被拦文件里的 JavaScript 也不会被执行——文档里有一句明确的结论:Google 搜索不会渲染被拦截文件或被拦截页面上的 JavaScript。
抓取阶段的解析是「经典网站」最容易通过的一关:当 HTTP 响应里的 HTML 已经包含全部内容(也就是服务端渲染)时,取回并解析就够了。麻烦的是应用外壳(app shell)模式的前端站点:初始 HTML 里没有真正的内容,必须执行 JavaScript 才能看到脚本生成的页面。谷歌的做法是把所有返回 200 状态码的页面排进渲染队列(除非 robots meta 或响应头要求不索引),然后在其资源允许时,用一个无头 Chromium 渲染页面并执行 JavaScript,再解析渲染后的 HTML、继续发现链接。
这段流程有两个容易被忽略的含义。第一,渲染是排队发生的,不是「抓一次就同时渲染一次」,队列时间没有承诺值;第二,前端的渲染依赖本身也可能被拦:如果页面要加载某个脚本文件才能显示内容,而那个文件恰好被 robots.txt 拦掉了,结果就是内容永远出不来。带上这两个前提,再回头看自家站点会更准确。
其他平台没有公开渲染说明,别替它们下结论
这一点需要说得谨慎。在 OpenAI、Anthropic、Perplexity 的爬虫文档里,能看到的是身份、用途、robots.txt token 与 IP 段这些内容,没有找到关于是否执行 JavaScript、是否渲染页面的说明。Bing 的爬虫文档提到会定期把网页渲染引擎更新到最新稳定版 Microsoft Edge,但那一段是在解释 Bingbot 的 User-Agent 字符串里会出现浏览器版本号,并没有说明哪些爬虫会执行页面脚本。
所以正确的说法是:谷歌公开了它的渲染流程;其他平台是否渲染、渲染到什么程度,属于没有公开文档的部分,不能靠推测写进方案。可操作的做法反而是通用的——把决策信息放进服务端返回的 HTML。这样无论对方渲染与否,内容都在那里。
哪些内容必须离开脚本
判断标准很简单:客户用来比较和决策的信息,如果只存在于脚本生成的区域,就有风险。对外贸与 B2B 站点来说,这类信息通常包括产品参数与单位、适配条件与限制、交期与最小起订量、认证范围、价格区间或询价方式、以及技术选型的判断依据。这些内容出现在原始 HTML 里,对搜索、对 AI 检索、也对禁用脚本或弱网环境下的访客都有意义。
可以留在脚本里的,是那些不承载关键事实的交互:轮播、筛选器、地图、在线配置器。它们让页面更好用,但不是别人需要读到的内容主体。
服务端渲染、静态化与客户端渲染怎么选
把关键内容放回 HTML,方案上通常有三种:服务端渲染(每次请求由服务器生成完整 HTML)、构建期静态化(发布时生成 HTML 文件)、以及保留客户端渲染但为重要内容做预渲染。三者的差别主要在维护成本和更新速度:服务端渲染适合数据经常变的页面,静态化适合内容相对稳定的产品页与文章页,预渲染适合短期止血。
不管选哪种,验收方式是一样的:用命令行取一次原始 HTML,看关键信息在不在;用禁用脚本的浏览器打开一次,看页面是否仍然可读。两项都能过,说明这个页面不依赖脚本执行也能被读到。要注意的是,这个结论只针对「能不能读到」,不推断任何平台会怎么处理它。
用两种方式取同一份 URL,自己验证
不用等任何平台的抓取日志,你现在就能做三件事:
- 用命令行工具直接取一次 HTML,在返回内容里搜关键参数的关键词。搜不到,说明它不在服务端返回的内容里。
- 在浏览器里禁用脚本打开同一页面,看剩下什么。这就是「只看初始 HTML」的视角。
- 用 Search Console 的网址检查工具查看 Googlebot 实际收到的 HTML,对照你自己看到的差异。这个工具反映的是谷歌在那一时刻拿到的内容,不是永久状态。
还有一类连带问题值得提前处理:如果脚本在加载后修改了 canonical、标题或结构化数据,那么「原始 HTML 的版本」和「渲染后的版本」可能指向不同的规范网址。这类冲突会直接影响页面以哪个版本进入索引,排查思路可以看canonical 加载后改变:SSR 与 hydration 冲突排查。
渲染确认完,下一步是把「能被抓到」变成「能被稳定地找到一个版本」:站点地图写什么、canonical 指哪里、索引状态怎么核对,这三件事的顺序在Sitemap、canonical 与索引的检查链里展开。如果你的站点正在做海外市场,希望把这些技术前提和内容策略一起评估,可以了解光算的 GEO 服务;具体做什么、做到什么范围,按项目实际情况确定。相关文件类话题另见llms.txt 的现状与边界。
延伸阅读,按你接下来要面对的下一步选:Javascript 渲染问题导致 Google 无法抓取内容的检测方法、Vue/React网站JavaScript SEO诊断:检查渲染、路由与内容可抓取性。
参考来源
- Understand JavaScript SEO Basics — 谷歌把处理 JavaScript 站点分为抓取、渲染、索引三个阶段,页面会同时排进抓取与渲染队列。
- Optimizing your website for generative AI features on Google Search — 谷歌说明只要脚本没有被拦截,它就能处理页面中 JavaScript 生成的内容,并建议遵循 JavaScript SEO 实践。
- Which Crawlers Does Bing Use? - Bing Webmaster Tools — Bing 文档提到会更新网页渲染引擎版本,但该段是在解释 Bingbot 的 User-Agent 字符串,并未说明哪些爬虫会执行页面脚本。
- AI Features and Your Website — AI 功能的 SEO 建议里有一条是确保重要内容以文本形式提供。
- Overview of OpenAI Crawlers(已通读,未发现关于是否执行 JavaScript 的说明) — OpenAI 爬虫文档说明的是身份、用途、robots.txt token 与 IP 段,没有渲染相关说明;Anthropic、Perplexity 的爬虫文档同样没有。因此「其他平台是否渲染」属于无公开依据的部分。