
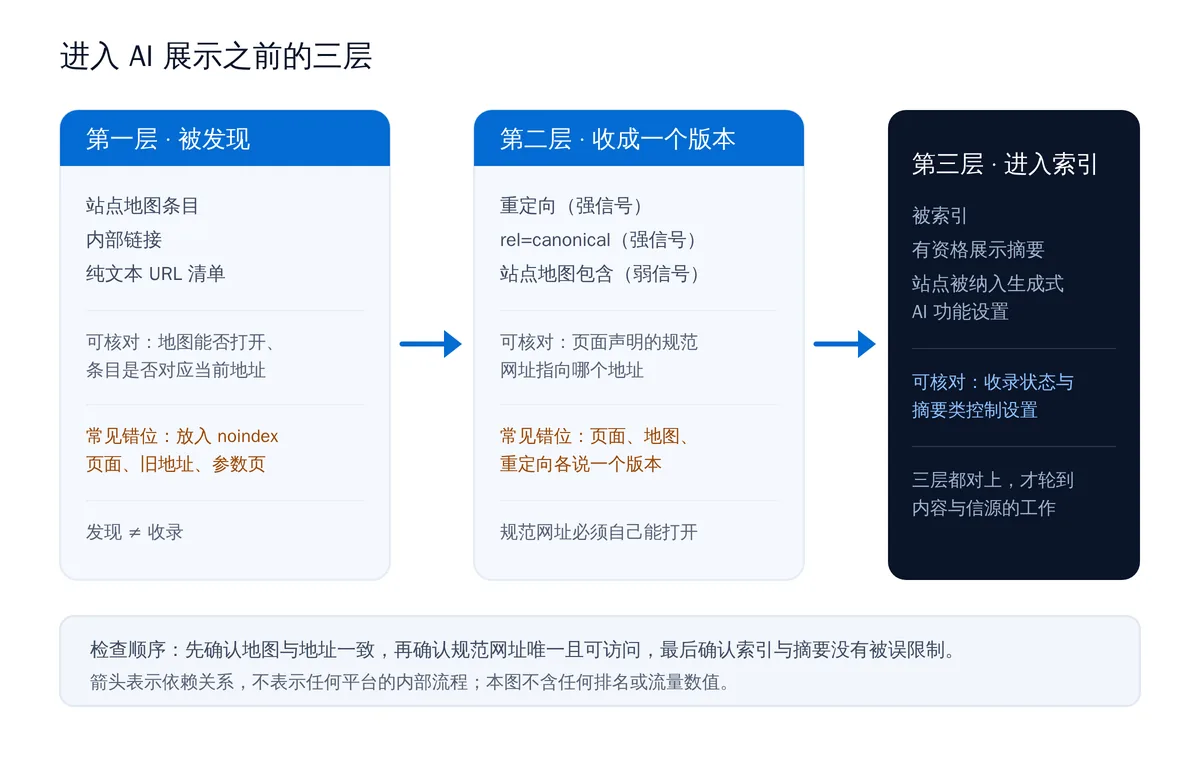
AI 检索要用的页面,得先经历三个动作:被发现、被认定成一个确定版本、进入索引。这三层任何一层错位,后面的优化都作用在错误的对象上。比如你一直在改的页面,早就不是搜索引擎认的那个版本。
第一层:被发现,不等于被收录
站点地图的作用边界,谷歌写得很清楚:它帮助搜索引擎发现你站点上的 URL,但不保证地图里的条目都会被抓取和收录。同一份文档还给了适用判断:站点很大、站点很新且外链很少、或者有大量视频、图片与新闻内容时,站点地图更有价值;如果是 500 个页面以内、内部链接完整的小站,通常没必要额外做。
地图里的字段也有讲究。谷歌明确忽略 priority 与 changefreq;lastmod 只在「一致且可核对(例如对照页面最后修改时间)」时才被采用,而且应当反映最后一次实质性更新的时间——改一次版权年份不算实质性更新。如果 lastmod 长期乱填,它的作用会消失。
第二层:把版本收成一个
同一份内容有多个可访问地址时,要明确告诉搜索引擎以哪个为准。谷歌列出的几种方式按影响力排序:重定向是最强信号,表示跳转目标应当成为规范版本;rel="canonical" 链接标注也是强信号;站点地图包含则是弱信号。这几种方式可以叠加使用,同时用两种以上会提高你期望的版本出现在搜索结果里的机会。
同时也要接受一个事实:谷歌文档明确说这些方式都不是必需的,不指定规范版本时,谷歌会自己判断哪个版本在客观上更适合展示。所以 canonical 的意义是「提高确定性」,不是「绝对控制」。真正会制造问题的是自相矛盾——页面自己说 A,站点地图说 B,重定向又指向 C,这种状态下不同系统拿到的版本可能不一致,而 AI 检索要的恰恰是一个确定的页面。
这里还要说清一件事:索引状态是会变的,一次检查的结论只代表那个时间点。已经收录的页面可能因为改版、合并、robots 规则变化而退出索引;新发布的页面在几天内没被收录也未必是问题。把检查结论写成「某年某月某日,某页面处于某状态」,比写「已收录」或「未收录」更接近事实。
站点地图里不该出现的东西
发现层最常见的错误不是「漏了页面」,而是「放了不该放的页面」。被 noindex 的页面、带排序参数的列表页、已经重定向的旧地址、登录或后台路径、以及同一内容的多个重复地址,如果都写进地图,等于把抓取预算和判断成本花在你不希望被索引的对象上。写地图时按「我希望它以这个地址出现在搜索结果里」逐条问一遍,能过滤掉大部分噪音。
另一个常被忽略的检查是地图文件本身:能不能正常打开、返回的是 XML 而不是错误页、编码正确、条目数量与站点规模相称。地图从来访者的角度看只是一份文件,但它是三层里唯一由你完全控制的入口,把这部分做干净的成本很低。
如果地图、规范网址和索引状态都对齐了,还有一步值得顺手做:把这几项写成一份可以交给同事照着跑的检查表,写清每一项在哪里看、看到什么算通过。这类检查本身不复杂,复杂的是每次换人做时口径不同,做完之后无法和上一次对比。固定格式的检查表解决的就是这个问题。
第三层:进入 AI 展示的最小门槛
AI 功能对页面的技术要求其实比很多人想的简单。谷歌的原话是:要成为 AI Overviews 或 AI Mode 里的支持链接,页面必须先被索引、并且有资格在 Google 搜索中展示摘要,满足搜索的技术要求即可,没有额外的技术要求。同一条要求也在生成式 AI 优化指南里重复过一遍。
指南里还多了一句容易被漏掉的前提:站点需要在 Search Console 的生成式 AI 功能设置里被纳入,才具备在搜索的生成式 AI 功能中展示的资格。这个开关当前默认是包含,且已经面向所有站点开放,但它是一个真实存在的、可能被误关的选项;排查「某类展示突然没了」时值得先看一眼。
按这个顺序检查,比逐项优化省时间
- 抽查五到十个重要页面,各自记下三件事:URL 在不在站点地图里、页面声明的规范网址是谁、Search Console 里是否已收录。三项对齐才进入下一项。
- 核对站点地图的 lastmod 与实际内容更新时间是否一致,把明显对不上的先改对,再考虑别的动作。
- 确认规范网址指向的那个版本自己可以被访问、也没有被 robots 规则拦下。指向一个打不开或不允许抓取的地址,等于放弃这个页面。
- 检查预览与摘要类控制(nosnippet、data-nosnippet、max-snippet、noindex)是否有误伤。这些设置会限制摘要展示,而 AI 功能的前提之一就是有资格展示摘要。
- 记录检查时间。抓取与重新处理都需要时间,把「什么时候查的、当时结论是什么」写下来,下一次才有对照。
这三层对齐之后,才轮到内容与信源的工作。如果更新已经发出、AI 依旧复述旧版本,那多半是公开副本没收口,处理顺序见内容更新后仍被引用旧版本的排查;如果页面关键信息还在脚本生成的内容里,先解决渲染与原始 HTML 的差异。地图与收录数字对不上时,Sitemap 已发现网页如何对账可以避免把解析数量当成收录数量。需要把这些检查放进具体项目一起做,可了解光算的 GEO 服务,范围以项目确认为准。
和本篇直接相关的还有:SEO 中的 canonical 是什么意思丨如何在 SEO 中使用 canonical 标签、Sitemap提交了但只收录首页:怎样核对有效URL、内链和规范页。
参考来源
- What is a sitemap — 站点地图帮助发现 URL,但不保证地图条目都会被抓取和收录。
- Build and submit a sitemap — Google 忽略 priority 与 changefreq,只在 lastmod 一致且可核对时采用它,并要求它反映最后一次实质性更新。
- How to Specify a Canonical with rel="canonical" and Other Methods — canonical 化的几种方式有强弱之分:重定向与 rel=canonical 是强信号,站点地图包含是弱信号,可叠加使用。
- AI Features and Your Website — 进入 AI 展示的最小门槛是被索引且有资格展示摘要,没有额外的技术要求。
- Optimizing your website for generative AI features on Google Search — 除搜索技术要求外,站点还需在 Search Console 的生成式 AI 功能设置中被纳入,才具备展示资格。
- Search generative AI control - Search Console Help — 该控制项于 2026 年 8 月 31 日向所有站点开放,默认是「包含我的站点链接与内容」。