GEO
共 80 篇文章 · 第 3 / 8 页
-
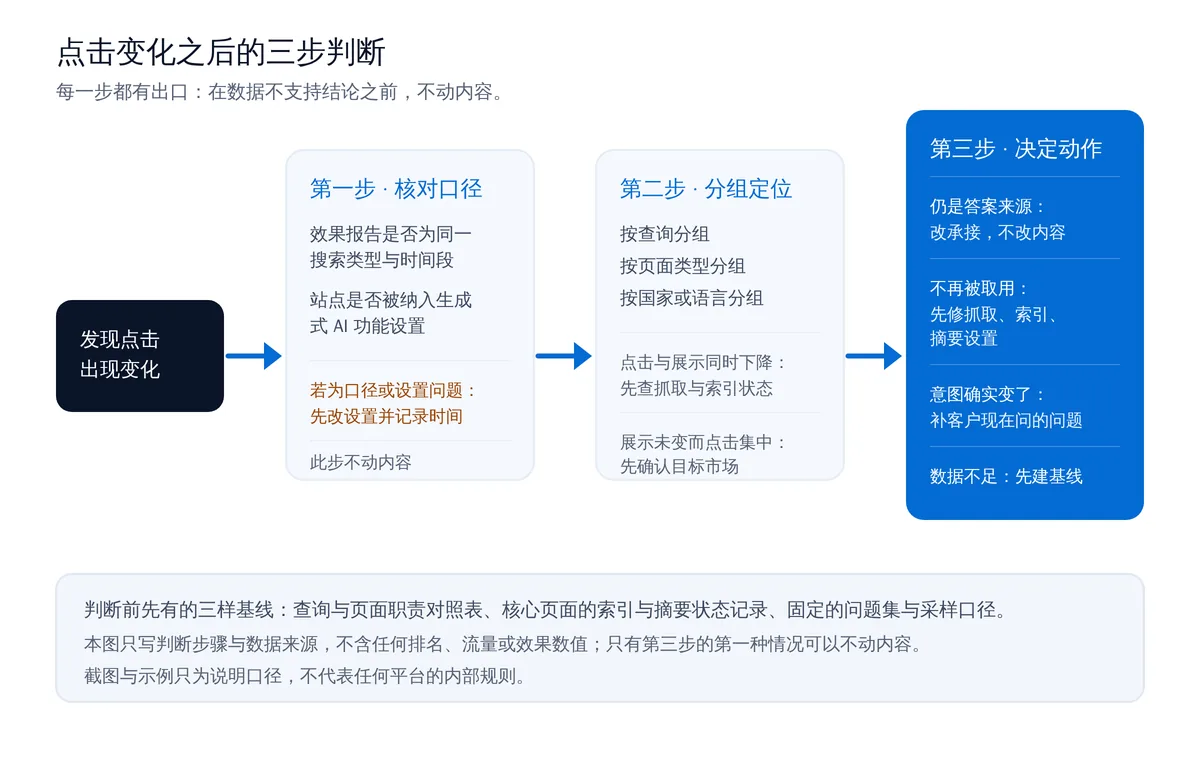
AI 搜索让点击下降:先判断是不是真的下降,再决定改不改内容
按三步判断顺序处理点击下降:先核对报表口径与生成式 AI 控制项,再把变化拆到查询与页面,最后按三类结果决定是否修改内容;另列判断前应准备好的三样基线。
-
品牌被提及 vs 官网被引用:两种可见度必须分开看
回答里出现品牌名与回答引用官网页面是两种不同证据。本篇给出官方对链接与来源的说明、两张记录表的最小字段,以及为什么不能合成一个可见度分数。
-
结构化数据对 AI 答案到底有什么用:能做什么,不能做什么
谷歌明确表示 AI 功能不需要结构化数据、也没有专用标记;它真正的作用是富媒体结果的展示资格。本篇核对官方说法、列出标记没有效果的常见原因与优先对齐的几类标记。
-
多语言与地区版本:hreflang 能做什么,AI 回答的语言又由谁决定
hreflang 解决的是搜索侧的语言地区指向,谷歌判断页面语言用的是算法而非 hreflang 或 lang 属性;AI 回答的语言选择没有公开规则,本篇给出可做的结构检查清单。
-
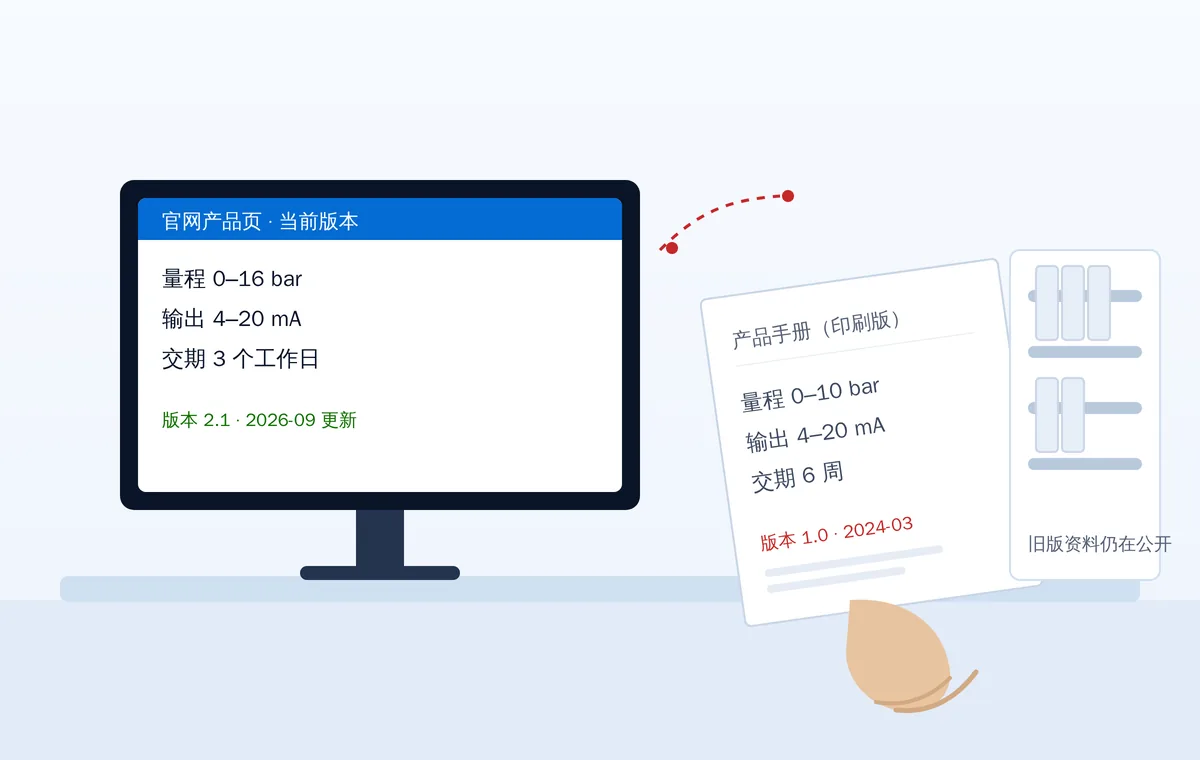
内容更新了 AI 还在引用旧版本:先查这五个公开副本
官网改完 AI 仍复述旧参数时,按官网历史地址、PDF 资料、第三方平台、多语种版本、缓存与归档五处逐项排查,并说明重抓时间不由站点控制。
-
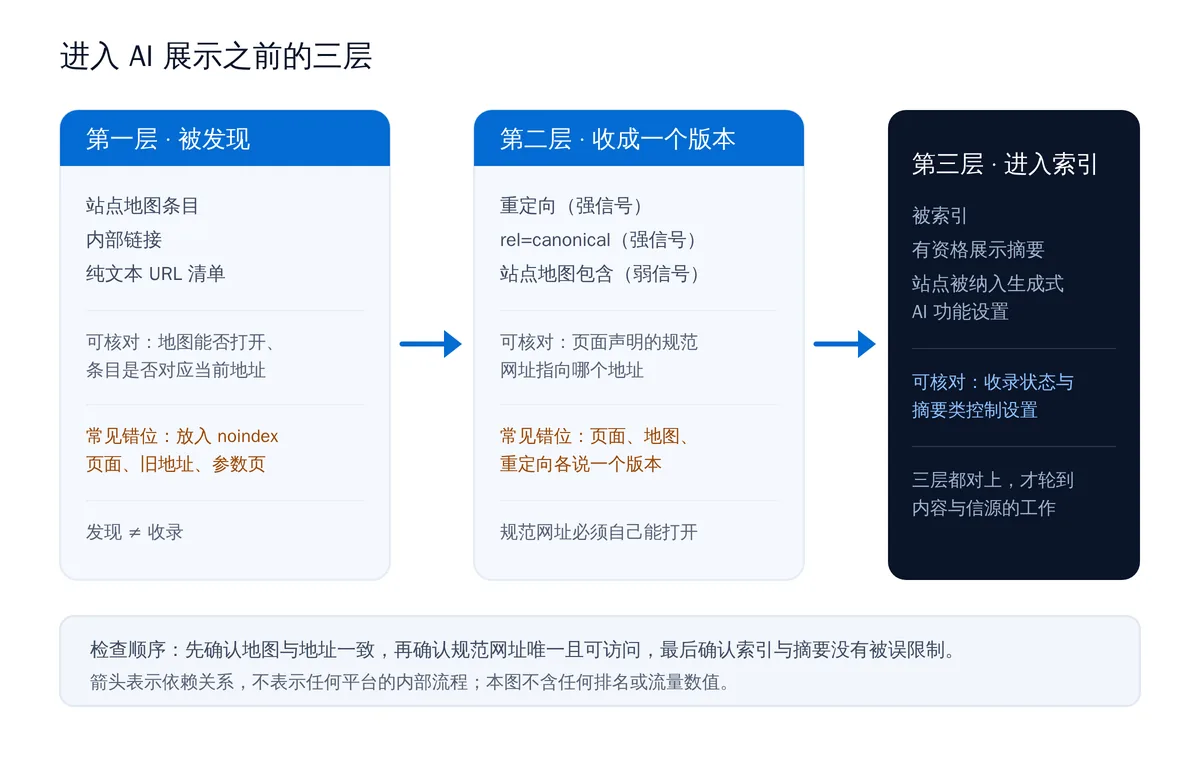
Sitemap、canonical 与索引:AI 检索之前先把这三件事对齐
把发现、规范化、进入 AI 展示三层放在同一条检查链上:站点地图的作用边界、lastmod 的正确写法、canonical 信号强度、以及进入 AI 功能的最小门槛与逐项检查顺序。
-
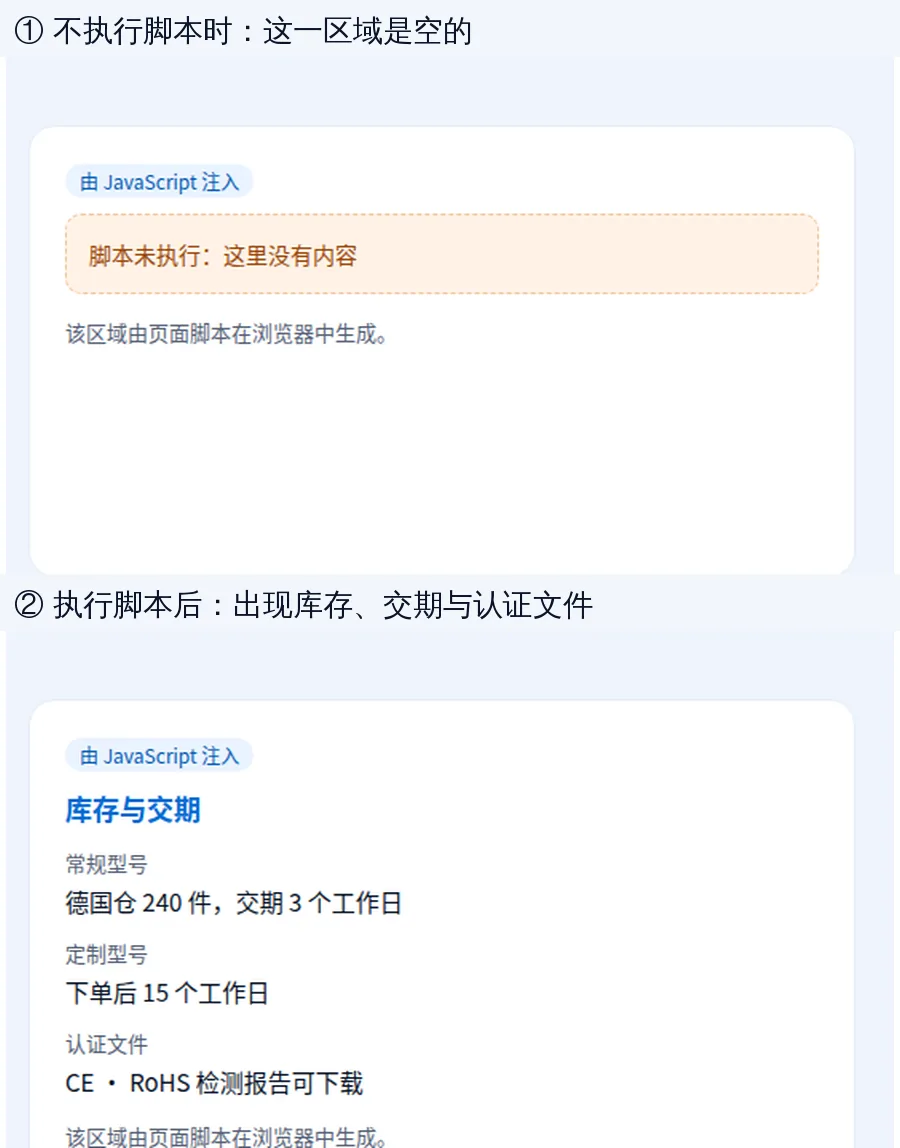
页面渲染与脚本:AI 抓取器看到的是哪一版内容
按谷歌公开的抓取、渲染、索引三阶段说明,讲清同一份 URL 的两种内容版本,哪些信息必须放回服务端 HTML,以及怎样用三种方式自查。
-
llms.txt 到底有没有用:现状、边界与正确预期
核对 llms.txt 提案原文与 Google 官方立场,说明它对搜索既不帮忙也不减分,并区分「文档站用它做索引」与「发布方写了一定被读」两件事。
-
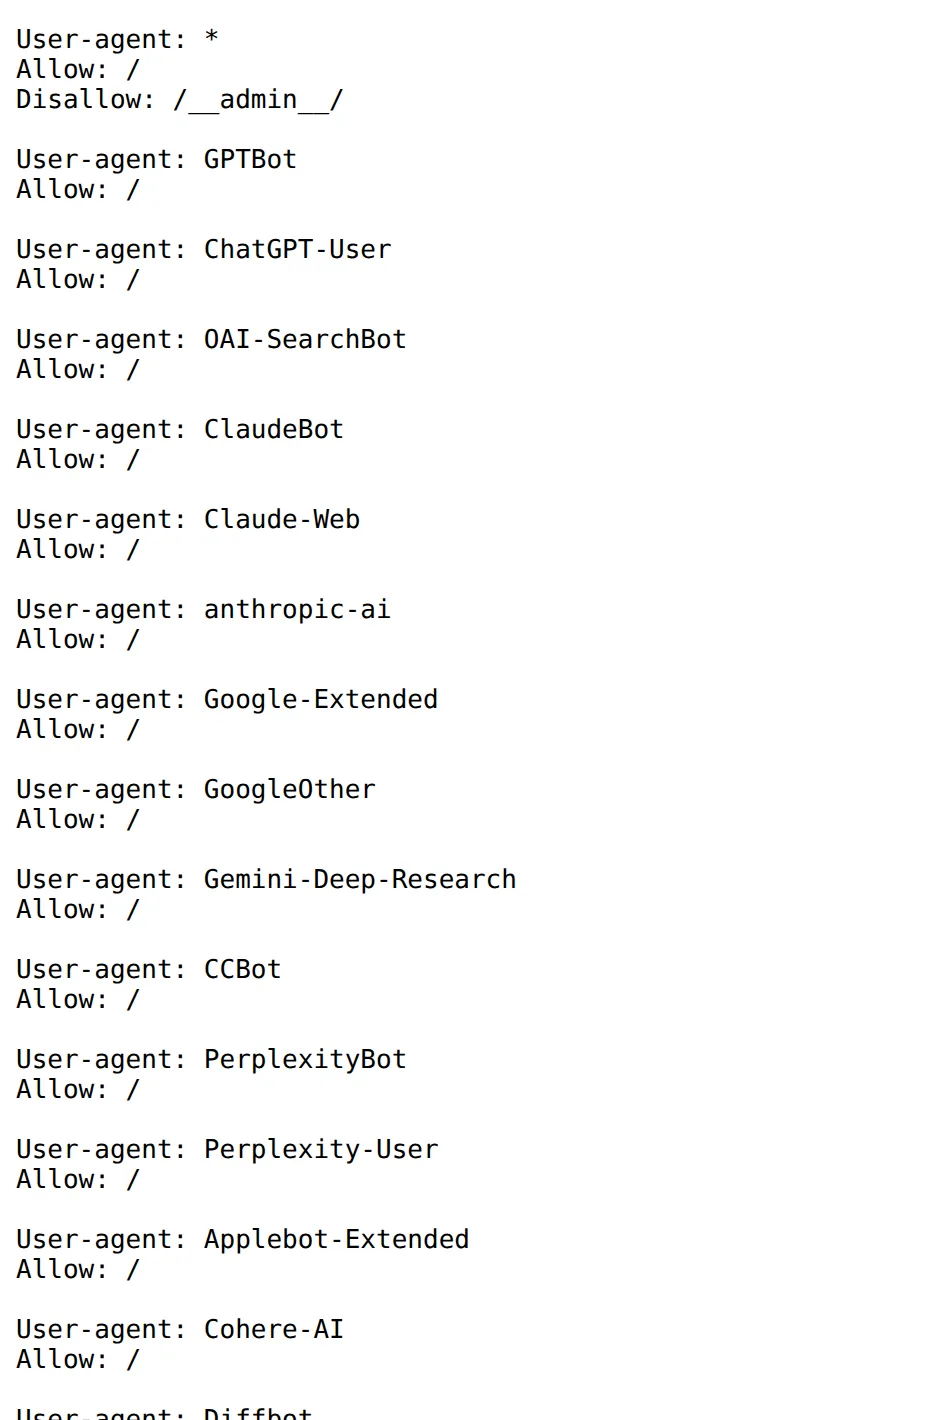
robots.txt 怎么配:允许还是禁止 AI 抓取,先分清要挡的是哪一类
把搜索索引、模型训练和用户触发抓取三类 token 分开,讲清 Google-Extended 与 Googlebot 的差别、分组与最长路径规则、Crawl-delay 谁支持,并用一份真实 robots.txt 逐行对照。
-
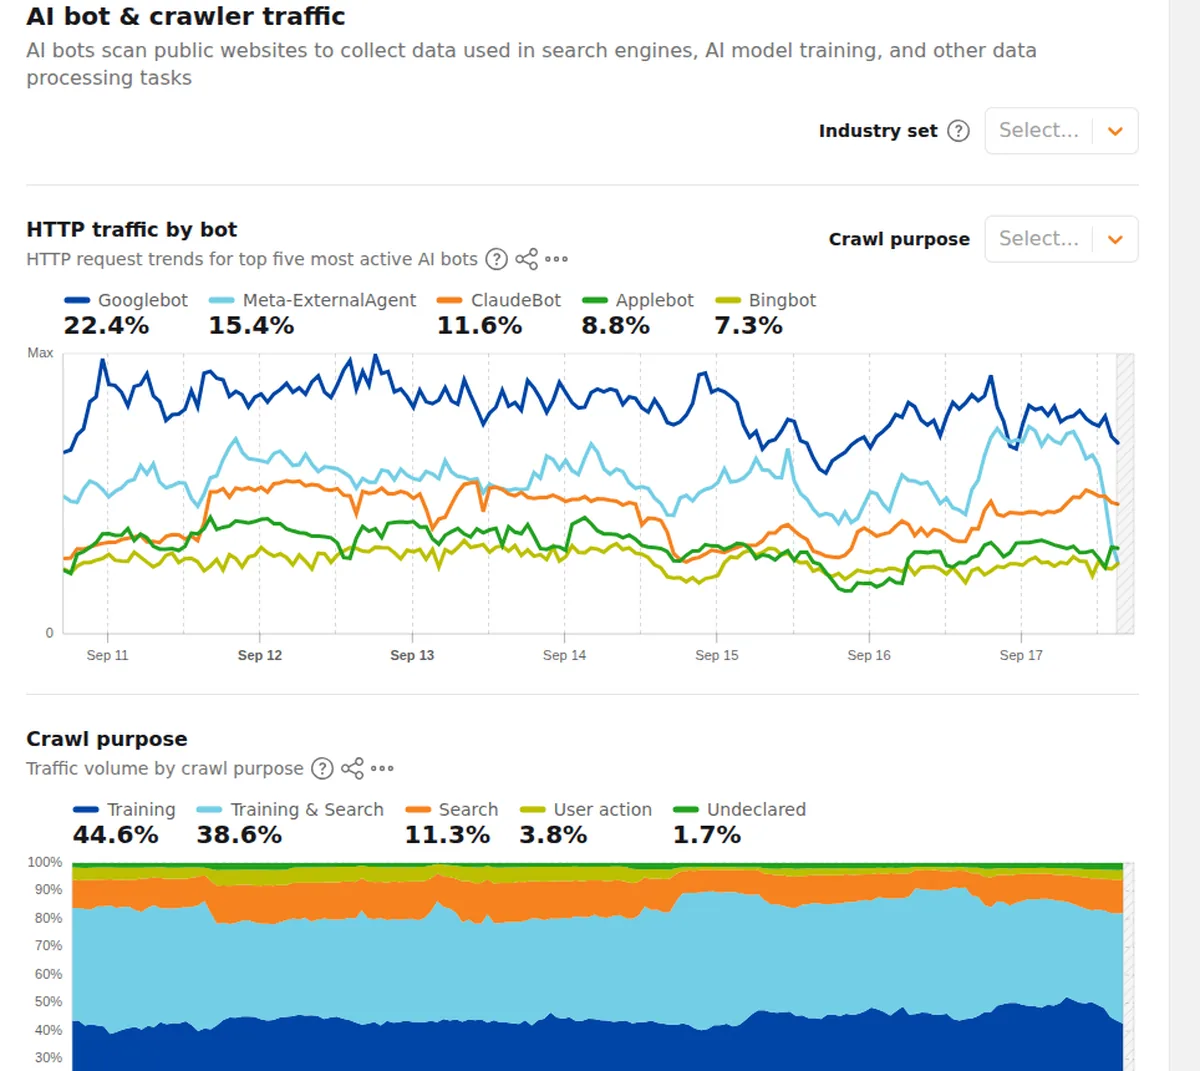
AI 爬虫盘点:GPTBot、Google-Extended、ClaudeBot、PerplexityBot 都在抓什么
按各家官方文档逐个核对主流 AI 爬虫的身份与用途,分清搜索索引抓取、模型训练抓取和用户触发抓取三类角色,并说明日志侧能核对到什么、核对不到什么。