
从 Search Console 导出效果数据时,同一条页面很容易在不同表、不同日期范围、不同筛选下重复出现。把几份 CSV 直接拼起来,就会出现“同一个页面算了两次”的问题;反过来,如果为了去重把参数和结尾斜杠一刀切掉,又会把本来就是不同页面、不同来源的行错误合并,甚至把广告活动流量并进自然搜索页。先定义“什么算同一个 URL”,再去重,才不会两难。
要区分三个层面:等价的写法(百分号编码大小写、主机名大小写、默认端口)、需要验证才能判断的写法(http/https、带不带 www、结尾斜杠)、以及绝对不能合并的写法(?utm_*、?gclid、分页/筛选参数、语言目录)。
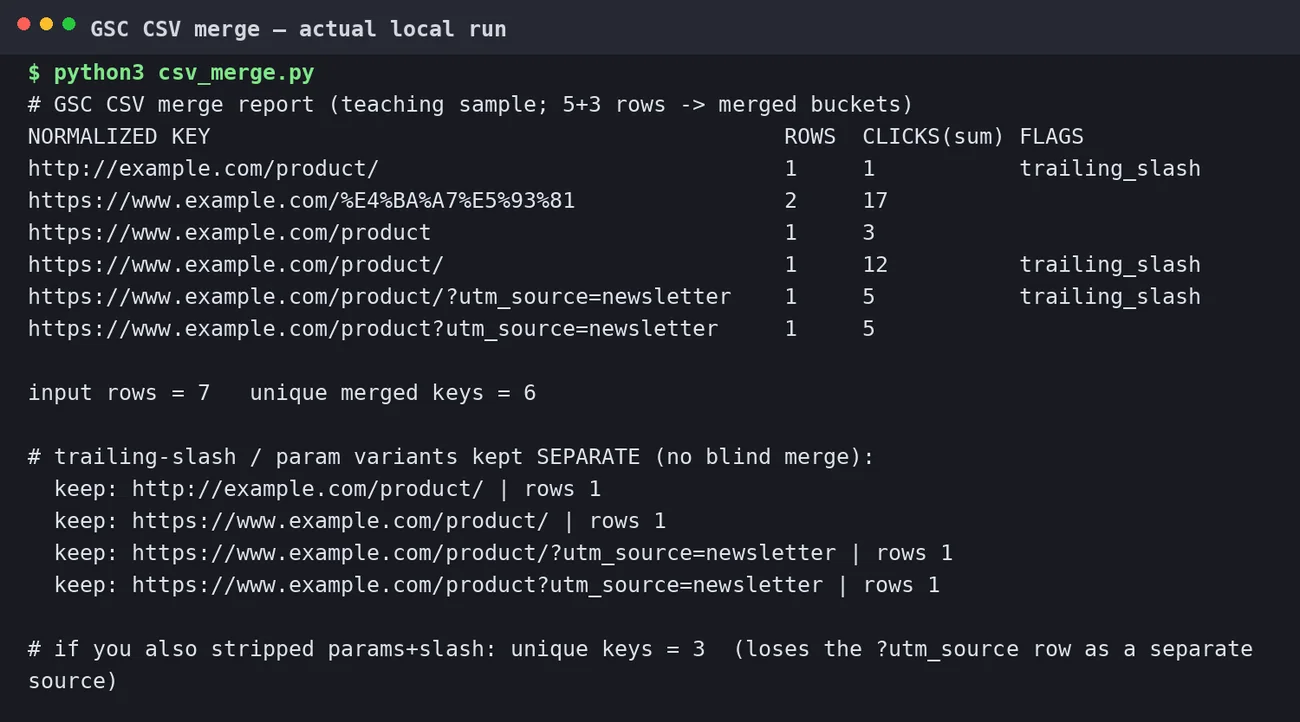
csv_merge.py(2026-10-02):7 行输入合并为 6 个唯一键,带 ?utm_source 的行没有被吞掉。先固定一个“合并键”,再谈去重
常见且安全的归一化,只做无歧义的转换:
- 协议和主机名转小写:
HTTPS://WWW.Example.com→https://www.example.com。按 RFC 3986,scheme 与 host 不区分大小写。 - 去掉默认端口:
:443(https)、:80(http)。 - 百分号编码统一十六进制大小写:
%e4%ba%a7与%E4%BA%A7是同一段字节。中文路径在导出里常是百分号编码,这一步很有用。 - 路径为空时视为
/。
做完这些,仍然“看起来一样”的行,才进入下一步判断。不要顺手 rstrip('/') 或 split('?')[0];那会悄悄改变语义。
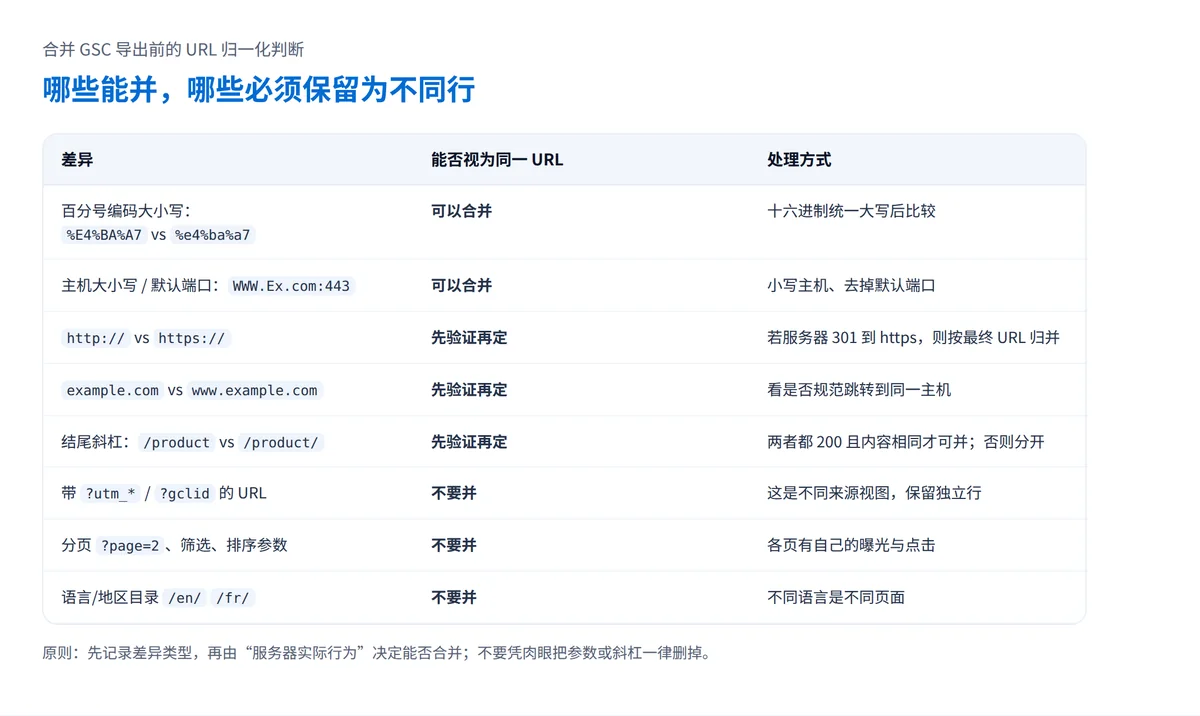
“需要验证”的三类:以服务器实际行为为准
- http vs https:如果服务器把 http 301 到 https,那么就按最终 URL 归并;如果两者都能 200(就是前面说的重复页与 canonical 问题),应分开处理并去修,而不是在表格里假装它们是同一个。
- 带不带 www:同理,看是否规范跳转到同一主机。若两个主机都能独立访问,导出的表现也是两个页面。
- 结尾斜杠:用一个真实请求验证
/product与/product/是否都 200 且内容相同;很多框架对两者行为不同,直接合并会出错。
绝对不要合并的
- 带
utm_*/gclid的 URL:它们代表不同的来源视图。把?utm_source=newsletter并进自然页,会让你以为自然流量变好了,实际是活动流量被错记。广告参数丢失的判断另见跳转后 UTM/gclid 丢失。 - 分页、排序、筛选参数:
?page=2、?color=red各自有独立的曝光与点击,合并会掩盖某一页的表现。 - 语言/地区目录:
/en/与/fr/是不同页面,不能因为路径相似就并。
一个可复现的合并流程
- 每份导出保留来源标记(哪个报告、日期范围、筛选条件)。
- 用上面的“合并键”归一化,并把命中的差异类型记成一列
flags。 - 按合并键汇总点击/曝光;对 flags 非空或有查询串的键,单独打印出来人工确认。
- 用真实请求核对 http/https、www、斜杠三类;把结论写进规则文件,而不是每次凭感觉。
- 保存规则与输入文件的哈希,下次对比用同一版本。
当行数超过单次导出上限、或需要长期留存明细时,手工 CSV 就不再合适,评估导向见BigQuery 批量导出的前提与成本。若你只是想先把一批 URL 的页面标题取出来做对照,可参考把多个 URL 的标题导出到 CSV;分组统计则可结合GSC 正则分组。
资料来源
- RFC 3986 — Uniform Resource Identifier (URI): Generic Syntax(scheme/host 大小写、默认端口、百分号编码)。
- Performance report: Dimensions and data groupings — Search Console Help(导出与数据分组说明)。
- 本机运行
csv_merge.py,2026-10-02。