
客户问“能不能分析一下 AI 为什么引用别人不引用我”,很多团队的第一反应是找一份“被 AI 引用最多的网站名单”。名单可以看,但看完没法动手:别人的域名你复制不了。能改的是页面内部那些会被单独摘走的小块内容——一段定义、一张对照表、一行带口径的数字。这一篇只谈这一层:AI 回答里的引用落在页面的哪一块,以及那一块该写成什么样。
先把三种“看起来像引用”的东西分开
不同平台给出的可见证据不是一个量级,混在一起会得出错误结论。
- 可见的来源链接。Google 官方文档写明,页面要被当作 AI Overviews 或 AI Mode 的支持链接展示,前提是它已被索引、并具备在 Google 搜索中带摘要展示的资格,“There are no additional technical requirements”。换句话说,AI 展示没有额外的“AI 专用”门槛,但也没有任何提交入口。
- 域级标签。Perplexity 的帮助中心明确写着 “Perplexity rates the whole website a source comes from, not each individual page”,标签只分 Government、Academic、Trusted 三类,且“Labels are set by the source review process alone”。标签是整站的,不是某个页面的,所以它不能用来判断某一页是否被引用。
- 来源面板里的链接列表。ChatGPT 的回答可以点开引用、也可以展开 Sources 面板看到被引用来源。OpenAI 帮助中心同时提醒,结果和引用“can be incomplete, outdated, or incorrect”,并说明排序“using multiple factors”,且“Placement is not guaranteed”。这句话的另一面是:没有人能保证某一次回答会引用谁。
把这三种证据分开之后,能观察的部分就很清楚了:链接指向哪个 URL、链接出现在回答的哪个位置、回答里那句话是否真的由该页面支持。至于模型内部怎么排序、怎么打分,不在可观察范围内,任何“内部权重”说法都不该采信。
一段话能不能被单独摘走
AI 系统理解网页的方式和人不一样。Microsoft Advertising 的官方博客把这件事说得很直白:助手不会从上到下像人一样读页面,而是把内容“parsing”成更小的结构化片段,再把这些片段组装进回答。片段能不能被单独使用,取决于它脱离上下文之后是否还成立。
常见的写法问题有三个:
- 指代不清。“该型号在满载条件下为 68 分贝”里的“该型号”如果离开上一个小节就无从判断,片段被摘走时就会变成一句无法核验的话。把主语写全,是这类段落最省力的改动。
- 结论和条件分离。把“适合连续运行”写在第三节,把“连续运行的工况上限是 X”写在第五节,被摘走的通常只有结论那句。条件要贴着结论写。
- 定义藏在叙述里。如果读者(和检索系统)要读完三段才明白这个术语在你的语境里指什么,那这三段就很难被当作定义来源。定义句放在小节第一段,是最容易被引用的位置。
数字要有口径,判断要有适用条件
被引用得最多的片段,往往是最具体的片段。但“具体”不等于“看起来精确”。
以教学样例说明口径该怎么写(以下数字为演示用,非真实测量):某条产线的节拍时间若写成“单件 42 秒”,读者无法判断这是实验室值还是含换型时间的现场均值。可用的写法是同时给出测量对象、条件、样本量与统计方式,例如“在 A 工况、连续 200 件、剔除换型时间的条件下,单件节拍中位数 42 秒,测量时间为 2026 年 3 月,样本为 3 条产线的现场记录”。
这样写有两个作用。第一,读者能判断这条数据是否适用于自己的场景,这是真实价值,不是为了让机器更喜欢。第二,当这段内容被引用时,限定条件会跟着一起出现,避免出现“某厂商宣称 42 秒”这类被截断的表述。
同样地,比较类内容要把比较维度写明。写“比同类产品快 30%”而不写基准,是典型的高风险片段:它看起来像结论,实际上不可核验,被引用后也很难收回。
同一页里,可引用单元分布在哪里
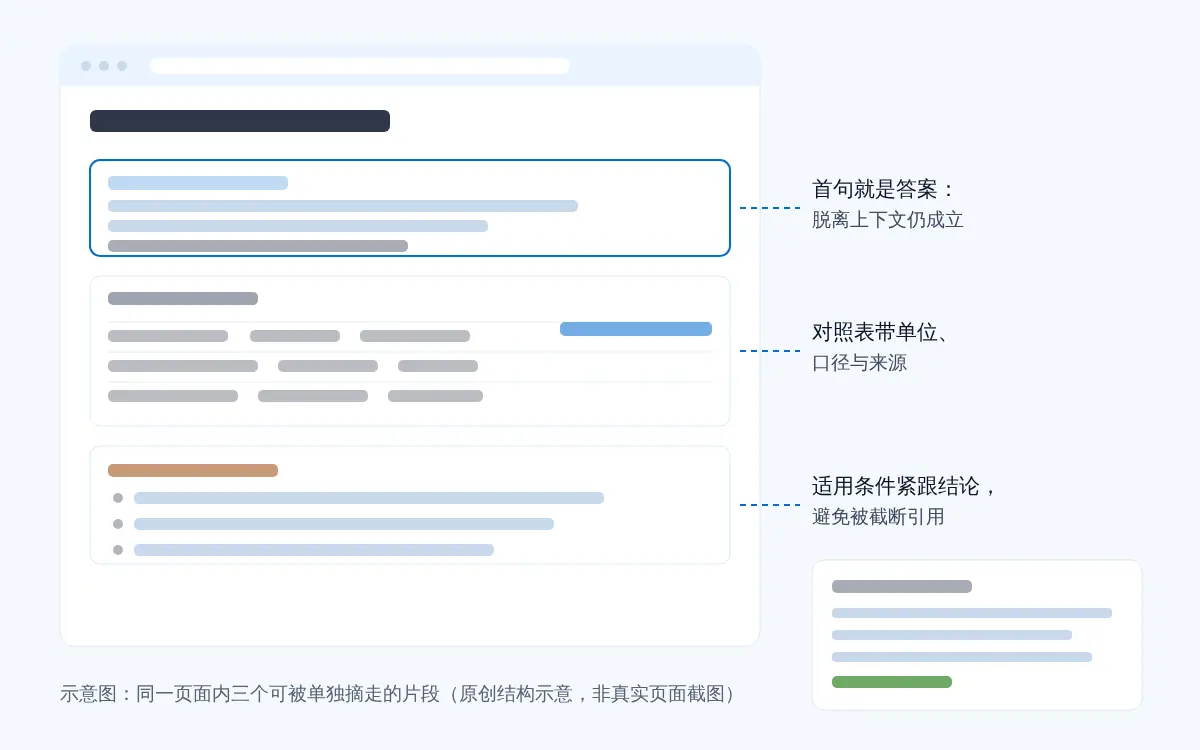
一个页面通常只会被引用一到两次,但如果页面里有多个彼此独立的可用单元,被命中的机会就不只集中在一处。实践中比较稳的分布是:
- 小节开头一句话直接回答这个小节标题提出的问题,让“标题+首句”成为一个完整答案。
- 中段放对照表或参数卡,把“选 A 还是选 B”的差异放在同一张表里,而不是分散在三段叙述中。
- 结尾或专门的“适用条件”段落列出限制、例外与不适用场景。这一段不容易成为亮点,但它决定了其他片段被引用时是否准确。
需要提醒的是,Google 对精选摘要的态度同样适用于这类结构判断:官方说明“You can't”通过标记把自己指定为精选摘要,Google 系统自行判断页面是否适合,而且不提供统一的最低长度要求。所以上面这些做法是提高可理解性的编辑判断,不是入选公式,也不该写成“这样写就会被引用”。
官方文档能证明什么、不能证明什么
把可核查的部分列清楚,比给出一个好听但无法验证的结论更有用。
- 能证明:AI 展示沿用基础搜索与内容质量原则,不需要虚构“AI 专用 Schema”;页面必须可索引、可抓取、允许生成摘要;生成式回答会做检索增强与查询扩展,Google 官方把后者称为 query fan-out,同一个问题会拆成多个相关子查询去取资料。
- 不能证明:任何具体来源的引用概率、某个写作模板的“必被引用”效果、以及各平台内部的排序因素。OpenAI 只写到“multiple factors”,Microsoft 写到“no secret strategy for being selected”,Google 写到 AI Mode 与 AI Overviews 可能使用不同模型与技术、因此展示的链接集合会不同。
把这两栏分开写进内部文档,能省掉很多无效讨论:前者可以排进执行清单,后者只适合作为观察记录。
下一步怎么落到具体页面上
如果要在这个季度内做一轮改动,建议的顺序是:先挑 5 到 10 个真实客户问题,在目标平台各查一次,把回答里出现的来源链接和相关句子一起截图存档;再对着自己的页面逐个检查,看哪些段落脱离上下文后仍然成立,哪些数字没有口径、哪些结论没有适用条件;改完之后用同一批问题复测,比较的是“这次被引用的页面和句子有没有变化”,而不是“排名上升了没有”。
愿意继续往下走的,可以接着看本组关于英文市场第三方来源类型的一篇,把自建页面和外部信源一起排优先级;如果更关心怎么把观察结果留成可复查的证据,可以直接看引用监测与证据留存。这两件事国内团队常混在“发稿”里做,其实执行对象完全不同。涉及具体行业的问题集设计、页面改造范围和复测节奏,光算会按项目现状逐项确定,GEO 服务里对交付边界和验收口径有完整说明。
另外几篇可以补充这里的判断依据:谷歌AIO(AI概览)引用来源分析:什么样的站更吃香。
参考来源
- AI features and your website — AI Overviews / AI Mode 对支持链接的资格要求。
- Google's Guide to Optimizing for Generative AI Features on Google Search — 生成式搜索沿用检索增强,并通过 query fan-out 拆分子查询。
- Searching the web with ChatGPT — ChatGPT 引用可见但排序不保证,且结果可能不准确。
- Understanding source labels - Perplexity Help Center — Perplexity 的来源标签是域级判定,不是页面级。
- Optimizing Your Content for Inclusion in AI Search Answers — 助手把内容解析成更小的结构化片段再组装回答,且不保证入选。
- Featured snippets and your website — 没有任何标记可以指定自己成为精选摘要,也没有统一最低长度。