
“AI 引用了我们”这句话,在多数团队里其实是三种完全不同的情况被混着说:回答里有指向自己页面的链接、回答里提到了公司名但没有链接、回答来源清单里出现了自己所在的域名。三者能证明的事情差别很大,监测表如果没有区分,做出来的趋势图就没有意义。
三种情况分别怎么判定
- 有可见链接。这是唯一能称为“页面级引用”的情况。记录时需要同时保存:回答里那句话、指向的具体 URL、链接在回答中的位置(正文内联、末尾来源列表、附图来源)。三者缺一,后续都无法核对“它到底引用了我们哪一页的哪句话”。
- 只提到品牌或数字,没有链接。只能记为“品牌提及”或“数据命中”。它可能有价值(说明信息被模型记住了),但无法证明来源是你,也无法证明读者能找到你。混进引用统计是最常见的失真来源。
- 来源清单里出现域名。以 Perplexity 为例,其帮助中心明确写着它标注的是整个网站(“Perplexity rates the whole website a source comes from, not each individual page”),标签只分 Government、Academic、Trusted 三类,且“Most domains on the web do not have a label”。域级标签不能用来判断某一页是否被引用。
快照要留哪些字段
一次完整的采样,至少保存这些信息,缺项要标注为缺项而不是留空:
- 采样时间(精确到小时,注明时区)。
- 平台与入口(哪个产品、网页端还是应用端、是否有联网开关)。
- 账号与地区(登录账号类型、出口地区)。同一问题在不同地区结果可能不同。
- 问题原文(逐字记录,不改写成更顺的表达)。
- 完整回答文本(不要只截取提到品牌的段落)。
- 可见来源列表(按页面顺序记录 URL)。
- 截图文件,命名规则与条目对应。
- 无法观察项:模型版本、检索到的候选集合、排序因素,一律写“无法观察”。
这套字段的价值在复测时体现:只有条件一致,两次采样才能比较。模型更新、入口变更、账号类型变化都要单独标注,不能和上一次硬做前后对比。
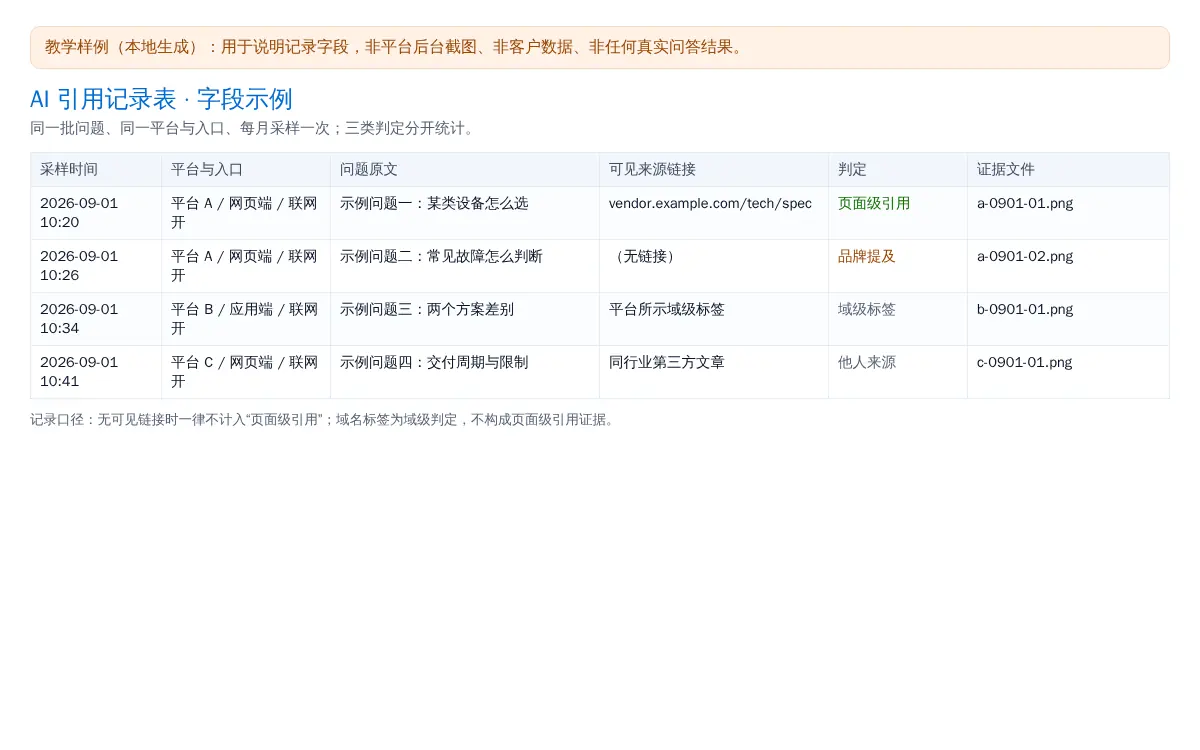
官方数据能证明什么
2026 年 2 月起,Bing Webmaster Tools 公开预览了 AI Performance 报表,这是目前少数由平台官方提供的引用数据。它对各项指标的定义写得很克制,引用时最好原样理解:
- Total Citations 是所选时间范围内“citations that are displayed as sources in AI-generated answers”的总数,官方明确它“without indicating placement or presentation within a specific answer”,也就是不含位置与呈现方式。
- Average Cited Pages 是平均每日被引用页面数,官方说明它“does not indicate ranking, authority, or the role of any page within an individual answer”。
- Grounding queries 是检索时使用的关键词短语,官方注明“The data shown represents a sample of overall citation activity”。
- 覆盖范围是它支持的 AI 表面(Copilot、Bing 的 AI 摘要以及部分合作方),并且“Bing respects all content owner preferences expressed through robots.txt and other supported control mechanisms”。
换句话说,这份报表可以证明“我们的某些页面在某段时间被引用过”,不能证明排名、权重或引用率。Google 与 OpenAI 目前没有同类页面级报表;OpenAI 帮助中心只写到排序“using multiple factors”且“Placement is not guaranteed”。
采样条件怎么控制
同一个问题在不同条件下会得到不同回答,所以采样条件必须写进记录,而不是只记答案。需要固定的有四项:一是入口(网页端、应用端、是否有联网开关、是否使用搜索模式);二是会话形式(新会话首问还是多轮追问,追问会显著改变回答范围);三是地区与语言(出口地区、界面语言、提问语言);四是账号类型(未登录、免费账号、企业版账号)。
如果团队同时用几台机器采样,建议固定一台设备与一个出口,其余设备只做补充观察,并在记录里注明。模型更新没有官方通知,所以每次采样记下客户端版本或界面标识,出现明显差异时先怀疑条件变化,再下结论。
引用句是否真的被页面支持
记下链接还不够,要回到链接那一页核对回答里对应那句话。核对分三种结果:
- 页面确实支持。把回答原句与页面原句都存下来,必要时截取页面局部,这是唯一可以写进“引用有效”的情况。
- 页面部分支持或换了口径。例如页面写的是特定工况下的数值,回答写成了通用结论。这类偏差最值得记录,因为它会误导读者,也是后续修页面的依据。
- 页面不支持。链接只是背景资料,或者回答综合了多个页面。这时如实写“来源不支持该表述”,不要凑成引用数。
这套核对办法同样适用于外部来源:竞品被引用时,也回原页面对一遍,往往能看出对方在结构或口径上做了什么你没有做的事。
把监测写进项目节奏
监测的用途不是出漂亮图表,而是决定下一步改什么。可用的做法是固定一批问题(含品牌词、品类词、选型词、故障词各若干),每月同一入口采样一次,按“页面级引用 / 品牌提及 / 域级标签”三类分别汇总,再把差异项(引用页变了、事实说错了、来源换成竞品)单列成待办。
其中“事实说错”这一类优先级最高,因为它会持续被复用;处理路径不只看答案本身,还要回到第三方页面上改源头,流程见外部内容与官网口径冲突。而如果复测发现被引用的页面从产品页变成了竞品的对比文章,通常意味着对方有更完整的对照结构,这类问题要在页面内部找原因,可以对照被引用页面的结构拆解逐项检查。
社区类来源也需要单独记一列:同一个结论可能来自 Reddit 的某个长帖而不是你的官网,这类情况在问答社区回答那一篇里讲了怎么写才有机会被引用。监测台账、采样频率与复测口径会随平台与市场不同而调整,光算在项目里通常先与客户确认问题集与测试条件,再开始采样,GEO 服务页写明了不承诺固定推荐位与全量监测的边界。
和本篇直接相关的还有:AI给出的引用看起来很真,怎样确认原文真的说过?。
参考来源
- Introducing AI Performance in Bing Webmaster Tools Public Preview — 官方页面级引用数据的指标定义与口径限制。
- Understanding source labels - Perplexity Help Center — 来源标签是域级判定,不能作为页面级引用证据。
- Searching the web with ChatGPT — 引用可见但排序不保证,结果可能不完整或过时。
- AI features and your website — AI Mode 与 AI Overviews 可能使用不同模型,展示的链接集合会不同。