
同一页面对Google适用的robots规则发生冲突时,采用更严格的规则。HTML写着index,HTTP响应头仍有适用的X-Robots-Tag: noindex,追加index不能抵消noindex。排查应先确定指令针对谁、在哪个URL的响应中出现,再找到生成限制的层,删除不该存在的输出,而不是继续叠加允许指令。
不要把robots.txt和页面robots标签混在一起
robots.txt主要控制抓取访问,HTML里的meta robots与HTTP头里的X-Robots-Tag控制页面索引及展示方式。Google需要能够抓取页面,才能读到其中的页面级规则。因此,“robots.txt允许”并不等于“页面允许索引”;反过来,页面写了noindex但抓取被禁止,也不能保证Google及时读取到这条规则。
Google的robots规范明确给出冲突时更严格规则生效的原则。这不是比较谁写得更靠后,也不是HTTP头天然覆盖全部HTML设置。先看适用对象,再综合对该对象有效的限制,才不会误删本来针对其他用途的规则。
把同一个GET响应里的两部分放在一起
使用开发者工具查看最终页面请求的Response Headers,再检查原始HTML中实际存在的robots meta元素。标签应规范地放在head中,但Google也会处理body中的robots meta,排查不能只扫描head。不要只看浏览器Elements面板,因为前端脚本可能在加载后改过标签;也不要把重定向入口的响应头误认为最终产品页的响应头。对多次跳转,逐跳记录URL和状态。
HTTP/1.1 200 OK
X-Robots-Tag: noindex

<meta name="robots" content="index, follow">
这段是教学示例,指令都针对通用爬虫。在这种组合下,index不抵消noindex。若页面确实应公开参与索引,应找出X-Robots-Tag的来源;若它本来是测试环境或私有内容,则先确认业务授权,不能因为看到冲突就机械移除限制。
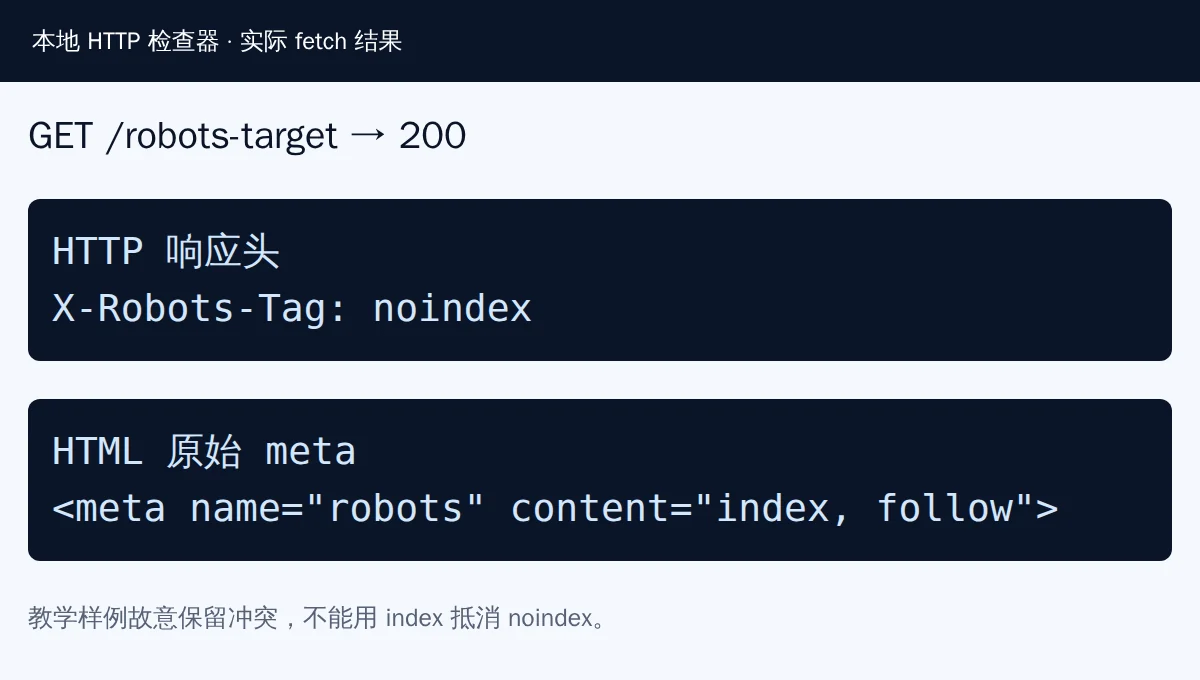
本地教学样例的实际HTTP响应检查截图;字段来自本地服务器的GET结果,不是生产站或Google索引报告。
爬虫定向规则不能只看单个词
meta name="robots"是通用规则,meta name="googlebot"专门针对Googlebot。响应头也可以包含爬虫定向范围。若robots为noindex、googlebot为index,通用限制仍对Googlebot适用,不能用后者当作“特别批准”。检查时应保留完整字段,不要把冒号前的爬虫名称截掉。
再看一个展示限制的例子:页面同时有max-snippet:50和nosnippet,Google文档说明采用nosnippet。它控制摘要展示,不等于noindex;同样,nofollow与noindex也不是一回事。恢复索引时,不应顺手取消版权方或业务方有意设置的摘要限制。
PDF、图片等非HTML文件也可使用X-Robots-Tag,不能因为没有HTML head就认为没有页面级控制。检查产品资料时,应分别访问文件URL与承载它的网页。网页允许索引并不能抵消文件自身的noindex,文件的设置也不会自动决定引用网页的所有展示方式。
找到是哪一层在追加指令
常见来源包括应用模板、SEO插件、Web服务器、反向代理和CDN响应头规则。先保存公网响应,再请有权限的人检查同URL的源站输出。如果源站有,继续追应用与服务器;如果只有公网有,优先看边缘追加与缓存。开发环境复制到正式域时遗留的全局noindex,也是值得核对的条件。
遇到多个X-Robots-Tag字段,保存完整集合。HTTP头名、爬虫名称及指令取值不区分大小写,不能因为写成大写就把限制漏掉。只取第一个或最后一个容易漏掉真正的限制。删除前明确规则作用范围:某条设置可能同时保护预览页、站内搜索或附件目录,不能为恢复产品页把整站限制全部关掉。更稳妥的修改通常是调整路径或环境条件。
如果源站已经正确、公网仍有旧指令,可继续看CDN旧noindex缓存排查。缓存滞留与配置持续追加都可能造成相同表象,前者需要失效旧副本,后者必须修生成规则;重复清缓存不会永久解决后者。
用具体组合检查,别只搜索noindex这个词
假设一条公开产品页的通用规则是index,Googlebot定向规则是noindex,应确认这个定向限制是否有意设置;如果是误配,修改对象就是对应输出条件,不必改动全站所有robots标签。另一条私有预览页即使使用相同模板,也可能仍需要限制,不能被产品页修复顺带开放。
另一个常见误判是从正文代码示例里搜索到noindex。正确转义后在pre或code中展示的示例只是可见文本,不是实际meta元素,也不是HTTP响应头;但body中若真的插入robots meta,Google仍可能执行它。检查工具应区分实际元素与转义文本,不能仅凭它不在head中就排除限制。
前端改标签还会带来时间顺序问题。按Google的JavaScript SEO说明,如果初始响应已经含noindex,不应依赖稍后的JavaScript把它删除来实现索引开放。应先在原始响应层输出正确指令,再检查渲染后没有被旧脚本加回。对搜索引擎而言,抓取和渲染并不是你浏览器里一条同步的可控流水线。
把这几类情况分别记录为通用规则、定向规则、示例文字和运行时变更,有助于避免脚本只凭字符串命中就自动修复。自动检查可以找疑点,最终修改仍要对应页面用途和规则来源。
修复的终点是正确响应,不是后台显示绿色
重新请求公开URL,确认状态、最终HTML、全部相关响应头和预期规则一致,再抽查同模板产品页与仍应受限制的页面。需要时使用Search Console实时测试检查Google能够获取的内容。实时结果通过,不等于索引数据库已经更新;应区分当前可读与后续处理。
光算的谷歌SEO服务可结合项目安排网站技术建议与标签排查。交付时,把“哪个URL、哪条指令、哪一层生成、修改前后怎样”写清,比“已优化robots”更有用。没有业务授权时,保留原有隐私和版权限制,并把存在冲突的页面单独列给负责人确认。