
后台取消noindex后,先看同一公开URL的实际GET响应。如果公网HTML或X-Robots-Tag仍带noindex,而源站当前版本已经移除,应继续定位CDN缓存、边缘响应头规则或其他代理层。仅保存后台设置、清浏览器缓存或重新提交网址,都不能证明搜索引擎下一次收到的是新版本。
先同时保存响应头和HTML
noindex可能存在于HTML的robots标签,也可能由服务器或CDN通过X-Robots-Tag输出。浏览器“查看源代码”通常只能帮助检查正文里的标签,不能代替响应头检查。使用GET分别保存两部分,并记录完整URL、访问时间、状态码及重定向链。
curl -sS -D public-headers.txt \
  -o public-body.html \
  'https://example.com/products/part-a/'
这是只读教学命令。默认不跟随重定向,方便先看入口响应;如果出现跳转,再逐个检查Location目标,确认最终产品页。不要只用HEAD下结论,一些应用和边缘规则对HEAD与GET的输出不同。后台预览地址与正式地址也要分开,预览正常并不能代表公开入口正常。
Google的robots规则文档说明,页面级设置既可放在HTML中,也可放在HTTP响应头中,且只有允许抓取时才能被读取。排查时应把两类指令并列保存,不能看到一个index就忽略另一个noindex。
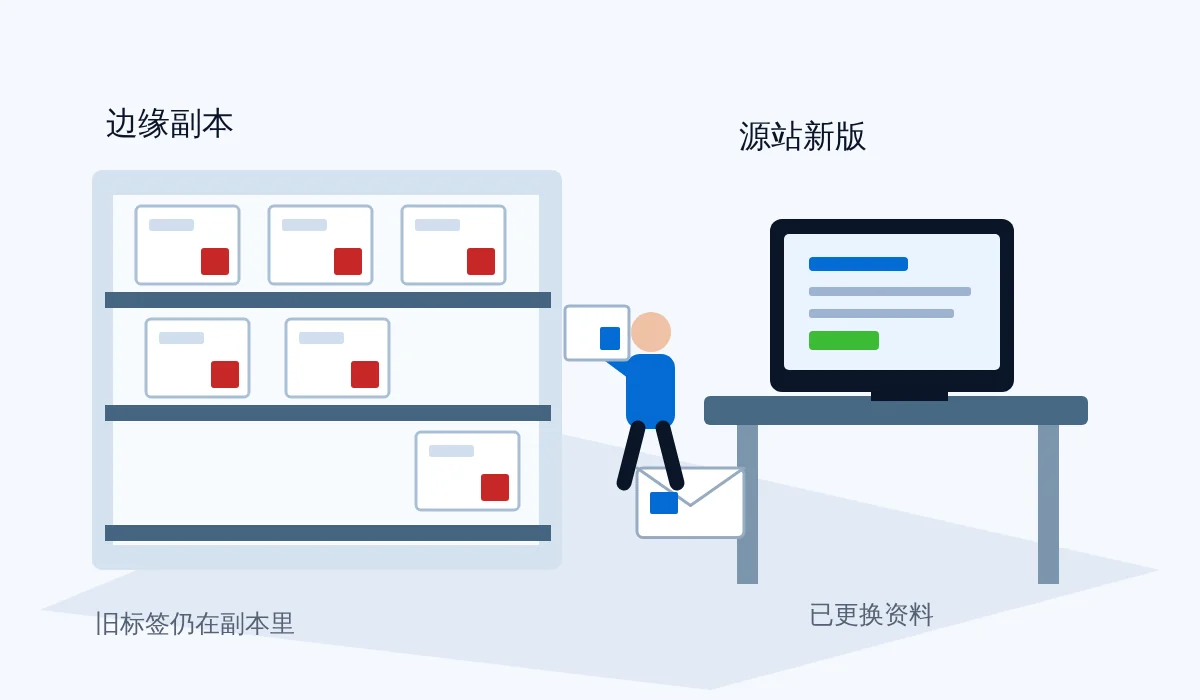
原创场景示意:源站资料更新与边缘副本更新是两个动作,图中颜色表示概念版本,不是监控数据。
怎样证明差异来自缓存,而不是又加了一次标签
让有权限的运维在保留相同Host、路径和HTTPS主机名的条件下检查源站响应,再与公网响应比较。不要为了排障公开源站地址或关闭访问保护。如果源站本身也有noindex,就先查应用模板、SEO插件或服务器响应头,CDN清理无法修复源头仍在生成的指令。
若源站没有而公网有,再看Age、Cache-Control、ETag及供应商提供的缓存命中字段。Age较大且显示命中,可以支持“正在使用副本”的判断,但Age缺失不能证明没缓存,ETag也不能单独证明正文正确。最好同时比对HTML里一段刚更新的独有文本,避免只盯着某个头字段。
还存在另一种情况:公网正文已经是新版,只有X-Robots-Tag继续出现。此时优先检查边缘响应头转换、路径规则或反向代理追加配置。缓存清理后头字段立即再次出现,通常意味着仍有生成它的规则,需要定位规则来源,而非不断重复清缓存。
只清受影响对象,还要核对缓存变体
确定问题对象后,用供应商支持的方式使相关URL缓存失效,并保留操作范围。协议、主机名、尾斜杠、查询参数、语言或设备分支,都可能形成不同缓存键。是否真的区分这些字段取决于当前配置,不能把想象中的键列表当作实际规则。
随便加一个随机参数访问,可能绕过旧缓存,却不能证明原始URL已修复。请求带Cache-Control: no-cache也只是要求重新验证的信号,不能代替检查CDN是否执行了相应策略。验收必须回到不带测试参数的正式URL,再看实际响应。
MDN的HTTP缓存说明区分了重新验证与不存储:no-cache允许存储,但复用前要求验证;no-store要求不要存储响应。二者都不是“删除所有历史边缘副本”的万能按钮。测试环境隔离、发布时的缓存失效和正确的缓存策略,应该分别处理。
取消noindex后,不要用robots.txt挡住复查
如果页面准备重新参与索引,应让Google能抓取到已经移除noindex的响应。用robots.txt禁止访问,可能使它无法看到新指令。若页面本来就因隐私或业务原因需要保密,则不能为了SEO擅自开放;noindex也不是访问控制,私有内容应使用真正的权限保护。
遇到头部与HTML相互矛盾,可按robots冲突的适用规则判断,不要在页面里连续追加index试图抵消限制。修复应删除不该存在的那一条输出,并确认本来需要保留noindex的页面没有被一起改掉。
用一张版本记录表思考,不必收集整站响应
对受影响URL可以逐条记录四个值:请求入口、正文特征、索引指令和缓存迹象。例如,源站已出现新的产品说明,公网还显示旧说明并带noindex,这支持旧副本滞留的方向;若两边正文相同但只有公网多出响应头,更值得查边缘头部规则。这里是判断示例,不是实际监测结果。
抽样应覆盖有差异的模板与主机,不必一开始就高频请求整个站点。尤其不要用大量随机参数探测缓存,参数可能触发昂贵回源,也可能污染后续分析。先用少量代表对象定位,再按配置确定真正受影响的范围。
修复后还可检查发布流程:正式内容上线前是否继承测试站指令,HTML与响应头是否由不同团队维护,缓存失效是否遗漏索引元数据。把产生旧noindex的条件写进发布检查,才能减少下次重复出现;单次清理只解决当前副本。
什么证据才足以结束这次排查
至少保留修复前后的同URL响应、源站与公网对照、受影响缓存对象和头部规则说明,再检查公开HTML里的标题、正文及索引指令。可从可用的不同网络入口抽样,但未覆盖所有节点就不要宣称全球缓存完全一致。后续还要查看真实Google抓取是否拿到新版。
光算的谷歌SEO服务强调先确认网站能否正常抓取和收录;此类项目可把响应检查、缓存策略建议及开发配合按实际范围约定。技术结论可以是“本次公开请求已没有意外noindex”,不能提前写成“收录已经恢复”。如果服务器把旧版本错误判成未修改,还应检查304与ETag的一致性。