
在 ChatGPT、Perplexity 或 Google 的 AI 回答里按行业问题问了一圈,同行的名字出现了好几次,你的官网一次都没被提到。客户搜索时能正常找到你,说明网站本身是活的;那问题通常不在内容好不好,而在两个完全不同的层面之一:检索方根本没取到页面,或者取到了却没有把它当成可用的来源。
排查第一步:分清是抓取问题还是内容问题
先说结论:官网在 AI 回答里完全不出现,通常只有两类原因。一类是抓取与托管层没放行,检索方根本没取到你的页面;另一类是抓到了,但页面没有被当作可用来源采用。两类的排查动作完全不同,先分清能省掉很多猜测。
Google 的官方说明里有一条很实用的排查顺序。在 AI 功能的落地建议部分,官方把“确保 robots.txt 以及任何 CDN 或托管基础设施都允许抓取”列在第一条。这句话点出了抓取层的关键:拦你的往往不是 robots.txt 本身,而是 CDN、WAF 或主机安全策略。这一层对内容团队不可见,却最常成为 AI 检索不到的真正原因。
抓取层要按顺序确认的四件事
第一,robots.txt 里对具体爬虫写了什么。robots.txt 的规则是按 user-agent 分组的,写法上字段名和值都不区分大小写。真实站点里常见的坑是:一大段 AI 爬虫的 user-agent 写在一组,末尾只有一个 Disallow: /,等于把整组一起拒了。
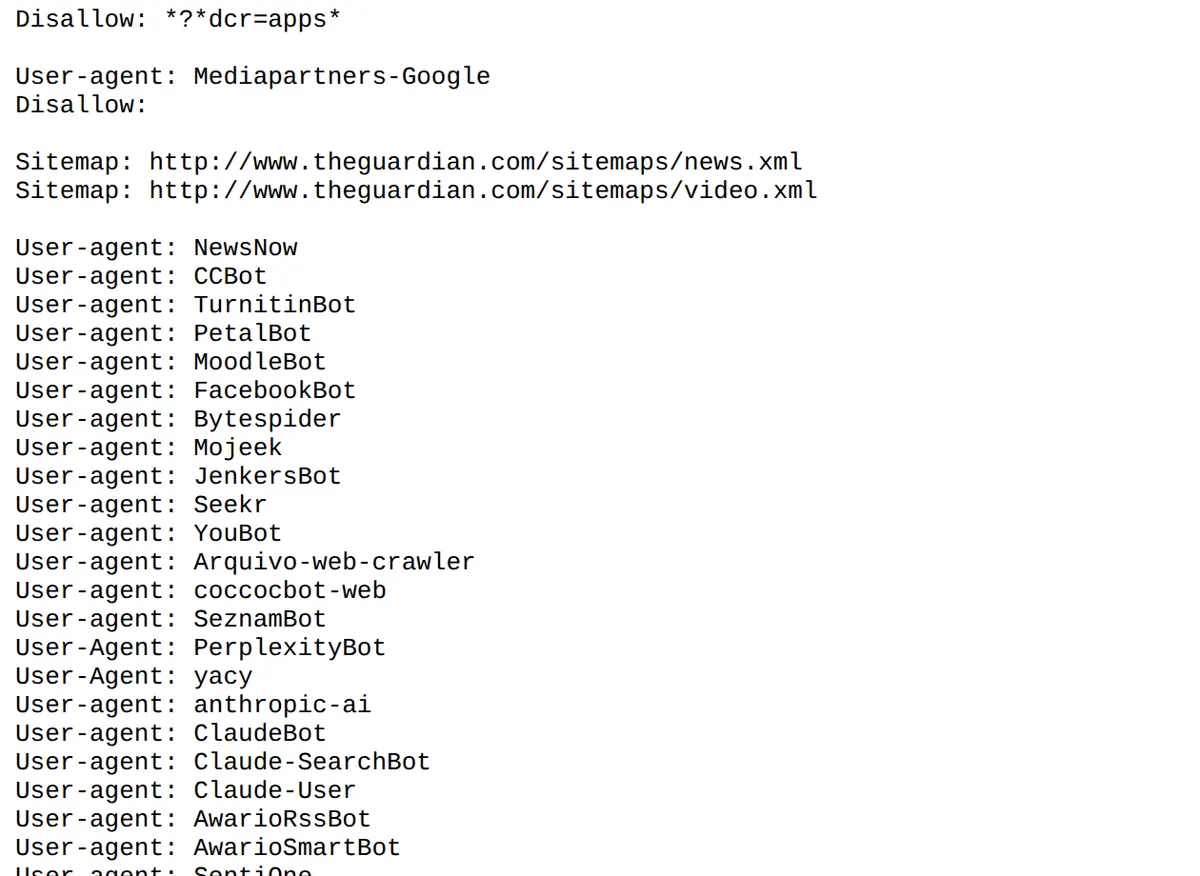
第二,CDN 与 WAF 有没有把爬虫当攻击流量。按 Perplexity 官方文档的说明,使用 Web 应用防火墙时,可能需要显式把它的爬虫加入白名单,官方还给出了不同 WAF 供应商的配置步骤,条件是同时匹配 user-agent 与官方公布的 IP 段。OpenAI 与 Anthropic 的文档也各自公布了 IP 段地址,供站点核对来源真伪。这意味着只认 user-agent 的放行规则不够牢靠,user-agent 可以伪造,IP 段才是可核对的依据。
第三,用户触发的抓取和自动抓取不是一回事。这一点最容易误判。Perplexity 文档写明,用户提问时触发的抓取“通常会忽略 robots.txt 规则”;Anthropic 也把 ClaudeBot、Claude-User、Claude-SearchBot 分成三个用途不同的机器人,并说明停用 Claude-User 会阻止系统在用户提问时取回你的内容。OpenAI 同样把 OAI-SearchBot 与 GPTBot 分开,前者的用途是让网站在 ChatGPT 的搜索功能里可被展示,后者的用途是模型训练。放开训练权限和出现在回答里是两件事,别用同一个开关处理两种目标。
第四,变更生效需要时间。OpenAI 与 Perplexity 的文档都写明 robots.txt 变更后系统调整大约需要 24 小时;Google 的说法更保守,重新抓取可能从几天到几个月不等,取决于系统判断页面是否需要刷新。排查时把这个时间窗算进去,避免在生效前反复改动配置。
内容层:被取到不等于被采用
抓取层通了,还要满足“能被摘录”的条件。Google 的官方要求是:页面必须已被索引,并且能带摘要出现在搜索里,除此之外不设额外门槛。注意这里的措辞是资格,官方同时强调满足全部要求也不保证被抓取、索引或展示。所以内容层的排查目标不是想办法提高概率,而是先排除自己造成的障碍:有没有 nosnippet、data-nosnippet、max-snippet 或 noindex 影响展示,重要内容是不是只放在图片里或依赖交互才能看到,同一件事在官网上是否只有一个说法。
还有一个常见误解值得澄清:新建 AI 专用文本文件或加特殊标记,并不会让内容更容易被取用。Google 的生成式 AI 优化指南明确说,站点不需要为此创建新的机器可读文件、AI 文本文件或标记;它同时说明这样做既不伤害也不帮助在 Google 搜索中的可见度。工具有没有用、适合哪个平台,要按各平台自己的文档判断,不要当成通用通行证。
多域名与多语种站点的额外排查
有多个市场版本的公司容易漏掉两处。一是 robots.txt 按域名与子域分别生效,主站放行不代表其他语言版本也放行;各子域的规则要各自确认,别用主站的结果推断全部。二是 CDN 与 WAF 的规则常常按域名或路径分别配置,主域名加过白名单,后来新增的市场域名可能没有同步。
排查顺序建议固定下来:先确认每个对外域名各自的 robots.txt,再确认这些域名的边缘配置是否一致,最后才回到内容层。语言版本之间还有一个容易忽略的点:如果某语言版本的页面数量很少、内容质量明显低于主站,那么即使抓取通顺,它在回答里被采用的概率也低,这属于内容问题而不是技术问题,两类结论要分开记录。
怎么记录这次排查
排查过程本身值得留档:测试的 URL、用的 user-agent、返回的状态码与响应头、检查时间、以及对比前后的结论。同一台机器上换 user-agent 再请求一次,是区分“规则拒绝”和“网络层拒绝”的最快方式,这一步不需要任何平台权限,也不需要登录后台。
如果抓取层已经放行、内容也没问题,但回答里仍不出现你的页面,那就换到另一个问题上了:页面有没有被当作可点来源,判断方法见 品牌被提到却没有链接时缺哪一环。反过来,如果回答里出现了你的品牌但说错了内容,处理顺序见 品牌事实被说错时先改哪里。
抓取层与内容层的检查可以并行做,但责任通常在两个团队手里。把这两类结论分开记录,能避免把托管配置问题当成内容质量问题反复返工;我们在这部分提供的是页面与信源的检查清单,范围按项目确定,说明见 光算 GEO 服务说明。
图片来源:机房照片为公开的 CC0 作品 Rear of rack at NERSC data center - closeup,作者 Derrick Coetzee,来自 Wikimedia Commons。
与这篇属于同一组问题的还有:产品页不被收录的6类技术排查:速度、robots、内链、渲染、URL与标签、抓取量下滑先看哪儿?用GSC主机状态区分DNS、连接与robots问题。
参考来源
- AI features and your website — 官方把确保 robots.txt 以及任何 CDN 或托管基础设施允许抓取列为AI功能的落地建议之一。
- How Google interprets the robots.txt specification — robots.txt 按 user-agent 分组,字段名和值都不区分大小写。
- Perplexity Crawlers — 使用 WAF 时可能需要显式把爬虫加入白名单,且用户触发的抓取通常会忽略 robots.txt 规则。
- Overview of OpenAI Crawlers — 搜索用途与训练用途的抓取是相互独立的设置,robots.txt 变更后系统调整约需 24 小时。
- Does Anthropic crawl data from the web, and how can site owners block the crawler? — Claude 侧把训练、搜索索引与用户触发抓取分成三个机器人,停用用户触发抓取会降低在用户搜索中的可见度。
- Google's Guide to Optimizing for Generative AI Features on Google Search — 不需要为AI功能创建新的机器可读文件或专用标记。