
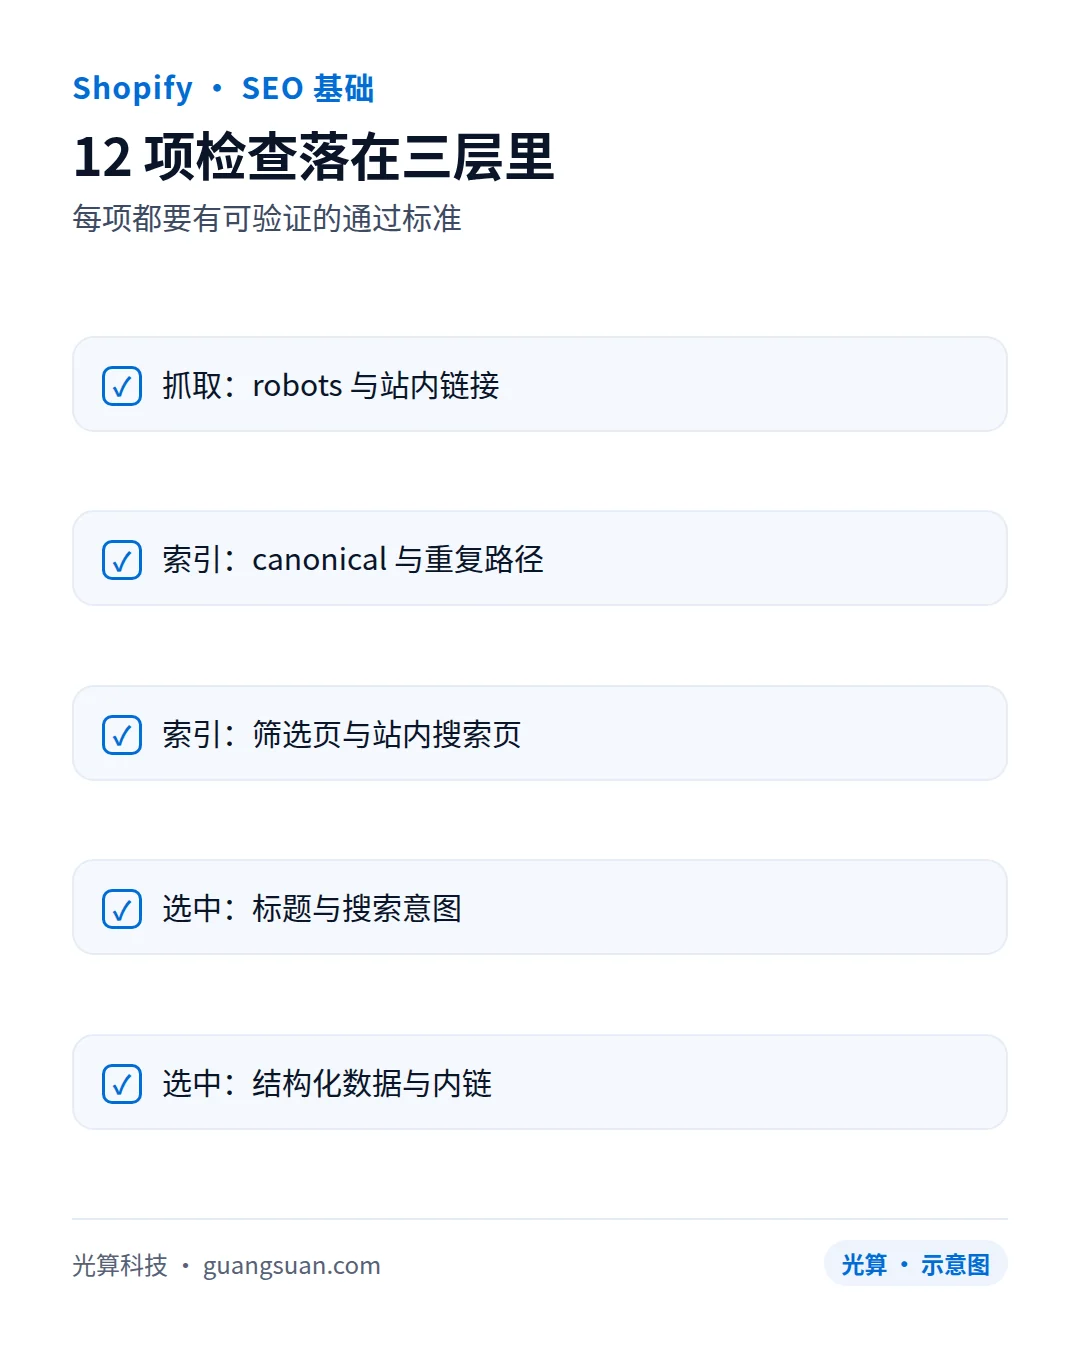
技术 SEO 出问题,很少是因为某一条规则写错,更常见的是顺序错了:先去改标题和描述,却没确认页面到底有没有被抓到。下面 12 项按「能不能抓取、能不能被索引、索引之后能不能被选中」三层排,每一项都写清在哪查、什么算通过。前一层不通过,下一层不用动。
三层顺序反了,后面基本白做
Google 索引页面时会先判断页面的主要内容,再把内容相近的页面归到一起,从中挑一个作为规范版本(见 Google 对 URL 规范化的说明)。这条链路很短:抓不到就没有索引,没有索引就没有排名。三层各自的判断对象不一样。
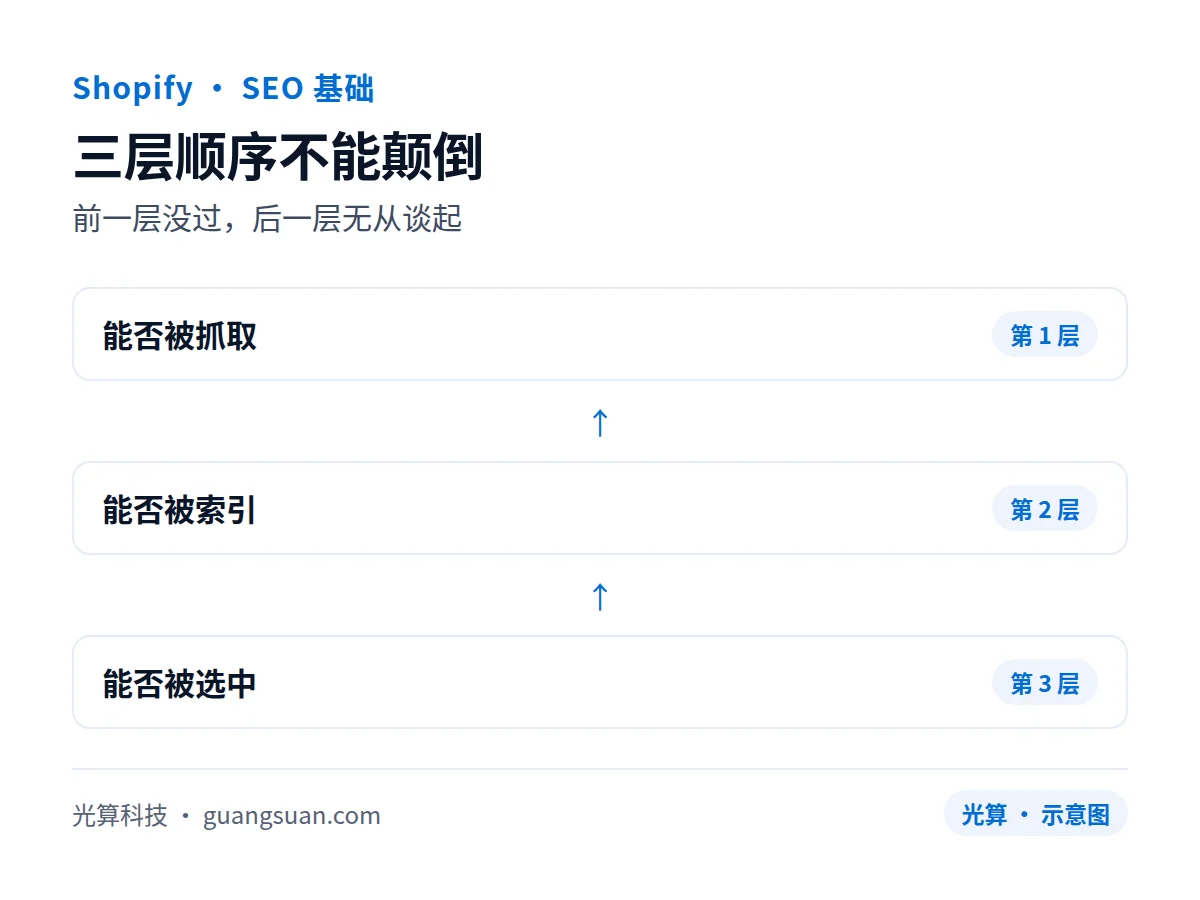
前一层没过,后一层无从谈起(光算 · 示意图)
- 抓取层看爬虫能不能访问到这些 URL:robots.txt 规则、sitemap 的可访问性、页面返回的状态码都属于这一层。
- 索引层看爬到之后允不允许收录、收的是哪一个地址:canonical 标注、noindex、同一内容存在多个可访问路径,都属于这一层。
- 选中层看索引之后搜索结果会不会选你:标题与描述、正文内容、内链、结构化数据影响的是这一层,其中内链的作用常被低估:同一条链接既影响页面被抓取的频率,也决定权重能不能传到这个页面。
跳过前两层直接做第三层是最常见的浪费。标题写得再准,页面本身带 noindex,或者同一件产品有三个可访问地址,效果都是零。层与层之间是串联关系,任何一层断掉,后面所有工作都不会体现在结果里。
12 项检查表,按层排开
表格里只写通过标准的摘要,判断容易出错的地方在后面的小节里单独说。
| 检查项 | 在哪查 | 通过标准 |
|---|---|---|
| robots.txt 是否放行 | 打开域名根目录的 robots.txt | 要收录的目录没有出现在 Disallow 里,sitemap 的地址仍然保留在文件中 |
| sitemap 是否可访问 | 打开域名的 /sitemap.xml | 根文件能打开,按类型拆分的子表也能逐个打开,条目不为空 |
| 协议与域名版本 | 无痕窗口分别访问几种写法 | 只留一个主版本可访问,其余不各留一份相同内容 |
| 站内搜索结果页 | 搜一次,看结果页源码里的 meta robots | 搜索模板带 noindex,且不出现在 sitemap 与导航里 |
| 筛选、排序与分页 | 点一次排序筛选,并打开集合或博客的第 2 页 | 参数组合不产生独立可抓取入口;分页地址能正常打开,也不与第一页内容完全重复 |
| canonical 标注 | 页面源码里搜 rel=canonical | 要收录的页面有一条指向自身版本的 canonical,不跨语言、不跨市场 |
| 重复路径 | 用集合内路径打开产品页 | 同一产品只有一套规范地址,两条路径不会各自声明为完整版本 |
| 重定向与失效链接 | 抽查改过地址的商品与已下架页面 | 旧地址有明确去向,不是直接抛 404 且无人处理 |
| 多语言与多市场版本 | 切换语言和配送国家 | 各语言版本互相指向并自引用,canonical 指向同语言版本 |
| 标题与元描述 | 编辑页面底部的 SEO 预览 | 每类页面有独立内容,没有模板残留的占位文字 |
| 结构化数据 | 页面源码里看 JSON-LD 或 microdata | 产品数据只有一套,价格与库存与页面显示一致 |
| 内链与图片 ALT | 源码与后台图片信息 | 重点页面能从菜单或正文到达;图片有描述准确的 ALT,装饰图留空 |
重复路径要在源码里确认,别靠感觉
Shopify 的产品页通常有两个可访问形态:产品目录下的规范地址,以及带集合前缀的地址。后者常出现在集合页卡片、站内搜索和外部链接里。判断方法很直接:把两个地址分别打开,各自看源码里的 canonical 指向哪里,再看搜索结果里实际出现的是哪一个。两条路径都声明自己是完整版本,就属于重复内容,需要让集合内路径收敛到产品地址;如果某次改动把 canonical 输出去掉了,也要在这一步补回。这个问题的排查过程写在 同一件产品出现两种路径的检查方法 里。
每项都要有可验证的通过标准(光算 · 示意图)
筛选、排序和站内搜索是三种问题
Google 把分类页的排序和筛选结果列为重复内容的常见来源之一(同一篇规范化文档里明确列出)。三类地址的处置方式并不相同:排序参数一般不产生独立入口,需要时统一规范版本;筛选组合要看有没有独立搜索需求,有需求的那几个值得做成真正的集合页,其余不要留可抓取入口;站内搜索结果页通常不该被索引,因为它对应的是无限组合的查询。
还要注意 noindex 和 robots 屏蔽不是一回事,用错工具会出现「结果里还能看到你的页面,只是没有描述」这种情况。筛选页与搜索页的判断顺序,以及主题层面怎么落地,写在 筛选 URL 与站内搜索页的索引判断。
分页要能抓,但别让它和第一页争同一个位置
集合和博客到一定数量会分页,第二页以后的地址同样属于可访问内容。这里容易出两个相反的错:一个极端是把分页地址全部屏蔽,结果列表深处的商品彻底失去内部入口;另一个极端是放着不管,让第一页和第二页互相抢同一批词。可行的做法是让分页页保持可抓取、能被链接到,同时明确它表达的是「这个分类的后续内容」,不是另一个分类。
分页页上的规范标注理论上指向自身,不要指向第一页——把第二页标成第一页的副本,等于告诉搜索引擎这些内容不存在。这一条属于行业里比较一致的经验做法,不是平台强制要求,你主题里实际输出的标注要以源码为准。
分页还容易和「加载更多」按钮混在一起。按钮如果不是真正的链接,列表深处的商品只能靠脚本才能出现,抓取时不一定被发现。判断方法很简单:在源码里搜有没有指向下一页的 a 标签,没有就是可达性的缺口。
结构化数据先看入口,再看字段
这一项经常被当成「需要自己做」的工作,其实支持的主题默认就在代码里带了 microdata,产品页包含价格、库存、评价这类信息(Shopify 关于 sitemap 与商品信息展示的说明)。检查重点因此在别处:主题改过、装过评论或比价类应用之后,一套数据有没有变成两套,标注里的价格和库存有没有和页面显示对不上。字段级核对清单写在 产品结构化数据的字段核对 里。
图片 ALT 是给两个读者写的
商品图会同时出现在商品页、集合页和 sitemap 的产品主图里,图片能不能被理解,一半靠 ALT 文本。判断标准和正文一样:这段文字是否描述了这张图实际展示的内容,而不是把标题里的关键词再抄一遍。装饰性图片留空比乱写更好,因为乱写的 ALT 会被读屏软件念出来,也会让图片搜索的匹配变差。分类图、横幅图、图标是乱写最多的一类,改动前先确认这些图片在后台有对应的字段可以填,不同主题和区块的位置不一样,以后台实际看到的为准。
改过 handle 的商品,验收不能只看页面能打开
产品地址改动会牵动三处:旧地址的去向、站内引用该产品的链接、以及集合页和文章里写死的地址。页面能打开只是第一层通过,改完 handle 后的核验清单 列了要一起查的位置。
平台本来就做掉的部分,不要重复做
Shopify 的 robots.txt 由平台生成,商家改动的入口在主题代码里的 robots.txt.liquid,而不在后台的 SEO 设置里(Shopify 的 SEO 文档目录 把这一项单独列了出来)。主题自带的微数据同样是默认存在的。图片则在后台统一管理(在线商店图片)。这些项目要检查的是「有没有被改动破坏」,不是「有没有从零搭起来」。robots.txt 具体能改哪一段、改错会怎样,见 robots.txt 能改什么、怎么验证。
边界要说清:第三方主题和后期改动可能把这些默认输出改掉,所以每一条都以你站点当前的源码和实际访问结果为准,别按官方主题的假设推断。sitemap 那一项也一样,它是平台自动生成和更新的,正常状态下不需要人工维护,真正要查的是它有没有被挡住或者读到旧版本,细节见 sitemap 结构与常见 404 排查。
标题、描述和正文是第三层的事
到了这一层再动标题才划算。产品页的字段取舍(handle、标题、描述、图片 ALT 分别怎么定)在 产品页 SEO 字段的取舍;集合页的标题、正文位置和内链安排在 集合页的写法与内链安排。两篇共有的前提都是前面两层已经通过。
这份清单多久重跑一次
换主题、装卸应用、上架一批新品、调整 URL 结构,这四种改动之后要把受影响的层次重跑一遍,这些动作很容易把原有的输出带走。日常运营不必每月全跑,把前三项和最后一项放进固定的季度检查就够,它们最可能在没人注意的时候被改坏。
清单跑完之后该看什么
建议一次只查一层,从抓取层开始,用真实域名而不是主题预览链接。改动前后各留一份结果记录,源码片段或访问结果都行,否则改过两轮就分不清是哪一步起了作用。前五项如果有问题,后面的先别动。
还有一件事要提前说清:这份清单解决的是「该抓的被抓、该收的被收」,不能保证收录数量和排名。平台文档本身写明抓取和索引需要时间且不作时间保证,canonical 的作用是表达偏好,Google 仍可能选择别的版本,文档里把这种声明称为提示而不是规则。如果自查之后卡在收录环节,光算的谷歌收录服务做的是抓取与索引层面的诊断和推进,与这里的技术自查是两件事,不要互相替代。