
先给结论:Shopify 的 robots.txt 不是你上传的文件,它由平台生成,你唯一的改动入口是主题里的 robots.txt.liquid。另一件更要紧的事,它不是用来阻止页面被收录的工具,拿它做 noindex 的活,结果通常和预期相反。
后台里找不到「编辑 robots.txt」是正常的
每个 Shopify 店铺在域名根目录下都有一份 robots.txt,由平台生成,访问 你的域名/robots.txt 就能看到。Shopify 的 SEO 文档把「编辑 robots.txt.liquid」单独列为一项(SEO 文档目录),这说明改动位置在主题代码里,后台没有上传入口。文件通常放在 Templates 目录下,不同主题版本的位置以你在编辑代码里实际看到的为准,不用花时间找「恢复默认」的按钮,它不存在。
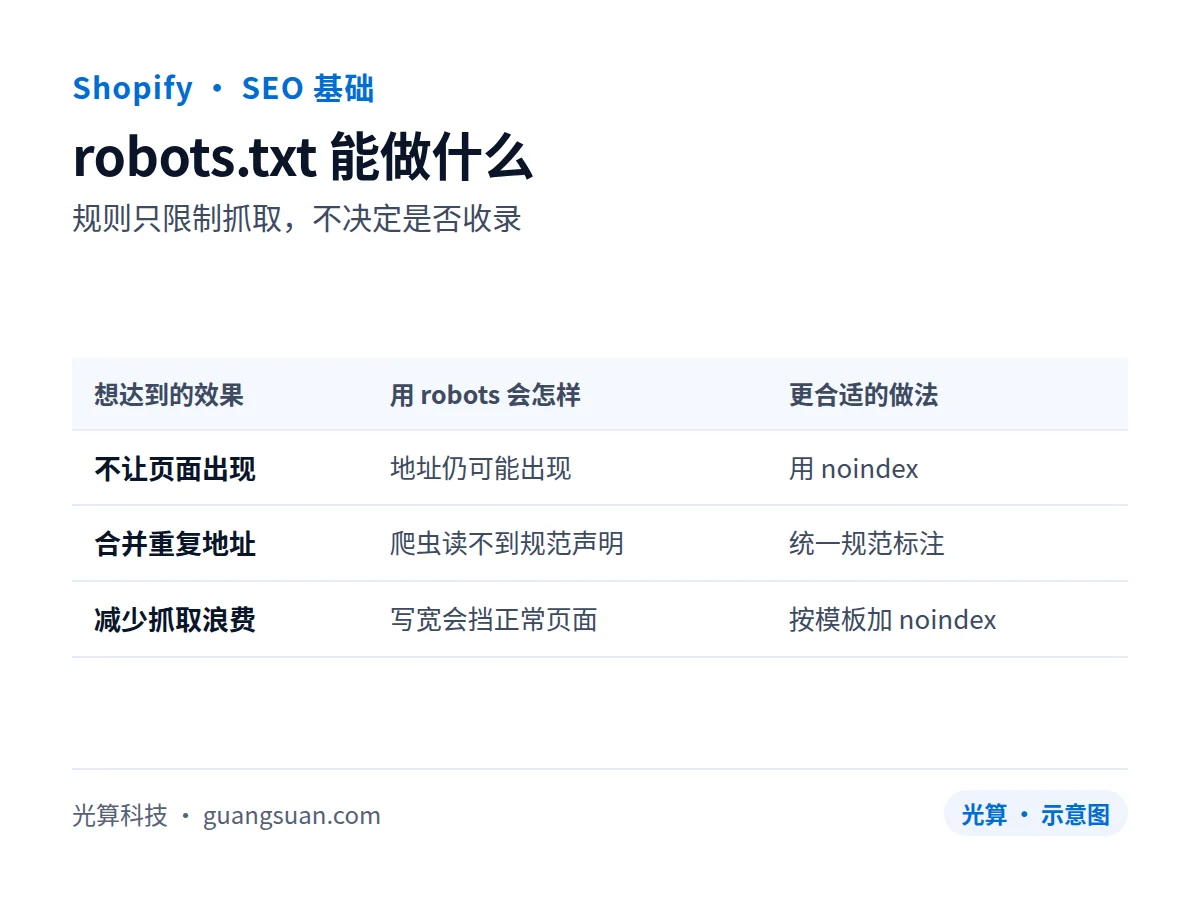
规则只限制抓取,不决定是否收录(光算 · 示意图)
由此可以得到两条限制:不能上传自己的 robots.txt 覆盖平台版本;也不能为不同爬虫返回不同文件,同一份文件对所有访问它的爬虫生效。
一次最小改动长什么样
下面的片段只做一件事,追加两条自定义规则,前面平台已有的段落保持不动。
# 追加在文件末尾,不要删除原有段落
User-agent: *
Disallow: /pages/old-campaign

# 只想屏蔽某个爬虫时,单独开一组
User-agent: SemrushBot
Disallow: /结构就三行:User-agent 说明规则对谁生效,Disallow 写不许抓取的路径,路径按前缀匹配。第一组对所有爬虫生效,第二组只对写明的那个爬虫生效。路径要换成你自己真正想处理的地址,上面那个只是示例写法。
换行和分组是容易踩坑的地方:同一个 User-agent 分组里写多条 Disallow 是正常的,两个不同分组之间用空行隔开;把同一组规则拆到两个同名分组里、中间隔着别的爬虫,不同爬虫的解析结果可能不一致。Google 的文档也提示不同爬虫对语法的解释存在差异(robots.txt 介绍)。改动原则只有一条:在文件末尾追加,不重写、不重排平台已有的段落。一次只加一组规则,验证通过再考虑下一条。
平台默认段落里已经有一批规则
打开你现在线上的 robots.txt,会看到平台默认写入的若干 Disallow 条目,覆盖后台、购物车、结账一类的路径,以及一条指向 sitemap 的记录。这些内容由平台维护,不必逐条背下来,但改动前必须先把当前文件整段复制下来作为基线。判断方法:改完之后把新旧两份内容对比,除了你新增的行,其他部分应当完全一致。先删再重写的做法很危险,可能把原本该挡的路径放出去,也可能反过来挡掉该抓的目录。
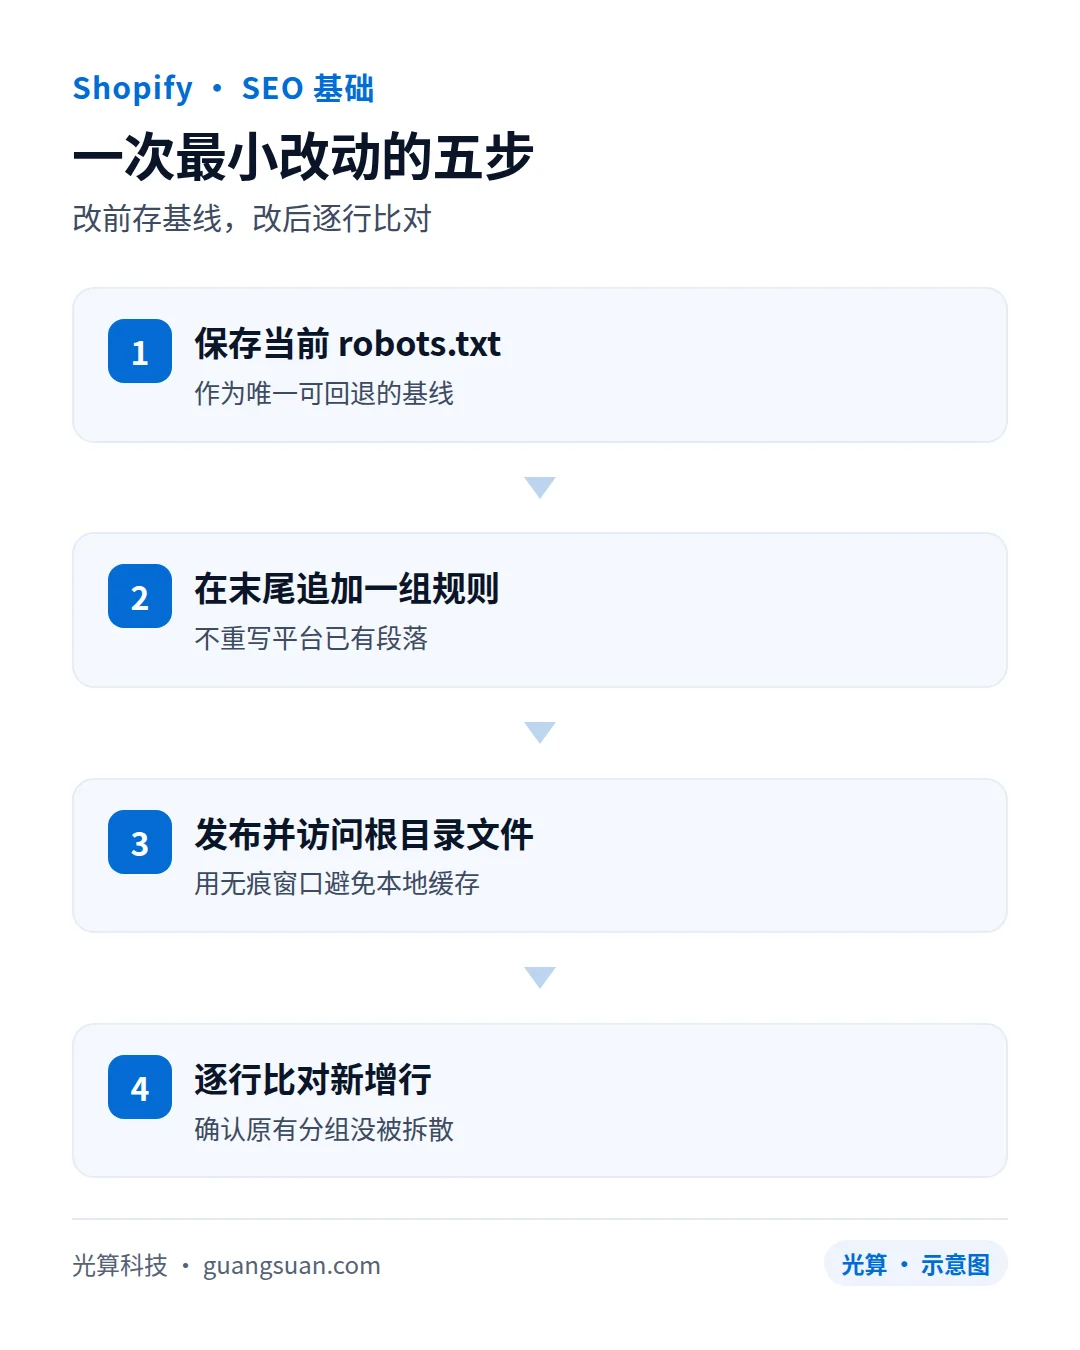
改前存基线,改后逐行比对(光算 · 示意图)
如果 sitemap 的地址要跟随当前域名输出,模板里可以写成 Sitemap: {{ shop.url }}/sitemap.xml 这种形式。用国际域名时每个域名都会生成自己的 sitemap(Shopify 关于 sitemap 的说明),Sitemap 行的实际输出要以逐个域名访问 robots.txt 看到的内容为准。
验证只有一条路:直接打开 /robots.txt
- 改动前访问
https://你的域名/robots.txt,把内容整段保存为基线。 - 在主题代码里修改 robots.txt.liquid。如果同时要动其他主题文件,先在副本主题里改好再发布,主题目录与文件职责见 layout、template、section 的关系。
- 发布后再访问同一地址,逐行比对,确认只多了你要加的规则。用无痕窗口,避免本地浏览器缓存干扰。
- 如果内容没有变化,先别重复改文件。robots.txt 在边缘节点上可能有缓存,刷新时间不确定,稍后或换个网络再访问一次。
- 如果打开后返回的是商店页面的 HTML 而不是规则文本,说明这个文件的输出已经被主题或应用改坏,先把它恢复成正常内容再排查。
比对时重点看三件事:新增的行是不是在预期的位置、原有的 User-agent 分组有没有被拆散、sitemap 那一行还在不在。只加一行却让整个文件结构变了,说明改的位置不对——在文件末尾追加和在分组中间插入,得到的结果不一样。
五步做完,这一项才算通过。这一步对应 从抓取到索引的技术自查清单 里的第 1 项,通过标准与上面一致。另外,搜索引擎要重新读取这份文件才会按新规则处理,这个时间由搜索引擎决定,不由你决定。
三种不该用 robots.txt 做的事
第一是阻止收录。Google 的说明写得很直接:robots.txt 主要用来管理爬虫抓取流量,并不是把网页排除在 Google 之外的手段;被 Disallow 的地址仍然可能出现在搜索结果里,只是结果里没有描述(robots.txt 介绍)。站内搜索页和筛选页是误用 Disallow 最常见的两个场景,判断顺序写在 筛选 URL 与站内搜索页的索引判断。
第二是代替 canonical。canonical 需要爬虫读到页面才起作用,被 Disallow 的地址爬虫根本不看,写在里面的规范声明等于没写。要合并的重复地址,用规范标注或统一入口解决。
第三是用一条过宽的规则处理参数。排序与筛选参数确实是重复内容的常见来源(URL 规范化说明),但把整个集合目录写进 Disallow,会把正常分类页一起挡掉,而 sitemap 里还列着这些地址,两边形成矛盾信号。集合页本身该不该写内容、参数怎么处理,见 集合页的标题、正文与内链安排;参数导致的筛选状态问题可以对照 排序后筛选丢失的排查。
四个误用对照着看更清楚。
| 想达到的效果 | 用 robots 会怎样 | 更合适的做法 |
|---|---|---|
| 让某个页面不出现在结果里 | 地址仍可能出现,只是结果里没有描述 | 用 noindex,或把页面删掉 |
| 合并两个内容相同的地址 | 爬虫读不到被挡的那个地址,规范声明无效 | 统一规范标注或统一站内入口 |
| 减少站内搜索页造成的抓取浪费 | 规则写宽会连正常页面一起挡掉 | 按模板给搜索页加 noindex |
| 保护内部资料 | 不遵守规则的爬虫照抓,地址也会被公开引用 | 密码保护或改为不公开 |
多数店铺其实不需要动这个文件
平台默认的规则已经挡掉了后台、购物车、结账这些不该被抓的路径,常规的商品结构也不需要额外规则。真正需要追加的情况很窄:某个应用生成了一批带参数、内容重复的地址;你有一个临时活动页或批发入口不想被收录;要针对某个采集类爬虫做限制。动手前先问一句「不加这条规则,实际会出现什么问题」,答不上来就别加。规则越多越容易互相冲突,几个月后也很难说清每条为什么存在。
判断标准可以更简单一点:一条规则的目的要能用一句可验证的话说出来,比如「挡住应用生成的重复列表页」。说不出来,这条规则就不该出现在文件里。
改之前先留一份能粘回去的内容
robots.txt.liquid 属于主题文件,改坏了没法从后台「恢复默认」,能依靠的只有你自己保存的基线。做法是改动前把文件全文复制到本地文本文件,命名带上日期;出现异常时先把文件恢复成基线,确认站点抓取状态正常,再一条一条重加规则。如果你不熟悉主题代码,就交给能操作主题的人来做,或者在副本主题里改好、确认文件内容无误再发布。
被挡住的地址,不要同时指望 noindex
常见的错误组合是:一个地址既写了 Disallow,又在页面上加了 noindex,以为上了双保险。实际只生效一半——爬虫不会去抓这个地址,也就读不到页面里的 noindex,而地址本身仍然可能出现在结果里。想彻底不收录,靠页面上的标注或把页面删掉;只想减少抓取浪费,才用 robots 规则。分工先想清楚,再动手改文件。顺序上,先确定这个地址最终要不要被收录,再挑工具,比反过来省事。
写错一行就能挡住整站
Disallow: / 是最危险的写法,一行就能让全站进入不被抓取的状态。它不会立刻生效,但搜索引擎下次读取 robots.txt 之后就会按新规则处理,恢复同样要再等一轮。改之前把原文件内容保存到本地,出问题先把文件恢复成基线内容,再慢慢排查。
另外两个边界:robots.txt 的规则不保证被所有爬虫遵守,非主流爬虫可能完全忽略它(同一份文档里列出了这条限制);它也不能用来保护隐私内容,需要保护的目录要用密码或其他访问控制。sitemap 被这条规则挡住时会出现什么现象,见 sitemap 结构与常见 404 排查。规则什么时候生效、爬虫是否遵守,都不在你控制范围内,能控制的只有文件内容本身。
最后一句提醒:这个文件常被当成技术实力的展示,实际上改动越少越好。它不能提升排名,也不能让某个页面更快被收录,能做的只是限制爬虫不去读某些地址。
- 规则不保证被遵守,非主流爬虫可能直接忽略。
- 生效时间由搜索引擎的抓取节奏决定,改完看不到变化属于正常。
- 它不能按访问来源区分,只能按爬虫标识分组,也不能替代访问控制。
改完之后还要回头看的两种情况
一是规则和 sitemap 的一致性。如果新增的规则把 sitemap 里列着的目录挡掉了,两边就是互相矛盾的信号,最终按哪边处理由搜索引擎判断,你没法预测。二是换主题或主题升级之后。robots.txt.liquid 是主题文件,换主题通常会把这份文件一起换掉,之前加的规则就消失了;主题层面的验收不止这一个文件,相关清单可以对照 主题改版的冻结清单与验收项。
如果排查的结论是抓取和索引在整站层面卡住,光算的谷歌 SEO 服务处理的是这一层,但 robots.txt 本身还得由你在自己的主题里改,改动前后的结果也要你自己验证。