
先分清你手上是哪种重复,这一步决定后面所有动作的方向。正文没翻译、只是导航和页脚换了语言,Google 会把它们当重复页;正文真的翻过,它们就不算重复,而是同一内容的本地化版本。同一个语言下因为币种、排序、筛选多出来的 URL 又是第三类,处理方式是合并,不是标记。
三类混成一类处理,最常见的后果是把翻得最用心的德语页 canonical 到英文页,等于主动放弃那批页面。所以第一步不是改代码,是分类。
三类重复,处理方向完全不同
| 类型 | 长什么样 | Google 的口径 | 处理方向 |
|---|---|---|---|
| 真翻译 | 正文已翻成另一种语言 | 属于本地化版本,不是重复 | 各自独立成页,加互指标注 |
| 半翻译 | 只译了模板,正文仍是原文 | 按重复内容处理 | 补齐正文再发布 |
| 同语言地区变体 | en-us 与 en-gb,语言相同 | 同语言地区变体 | canonical 与 hreflang 一起用 |
| 参数复制 | 币种、排序、筛选生成的 URL | 站点功能产生的重复 | 按价值合并或阻断抓取 |
这张表是有出处的。Google 的规范化文档 把地区变体、设备变体、协议变体、站点的排序筛选功能都列为重复内容的常见来源,并且单独说明:不同语言版本只有在正文仍是同一语言时才算重复。同一语言的地区变体,文档的建议是 canonical 和 hreflang 一起用,不是二选一。
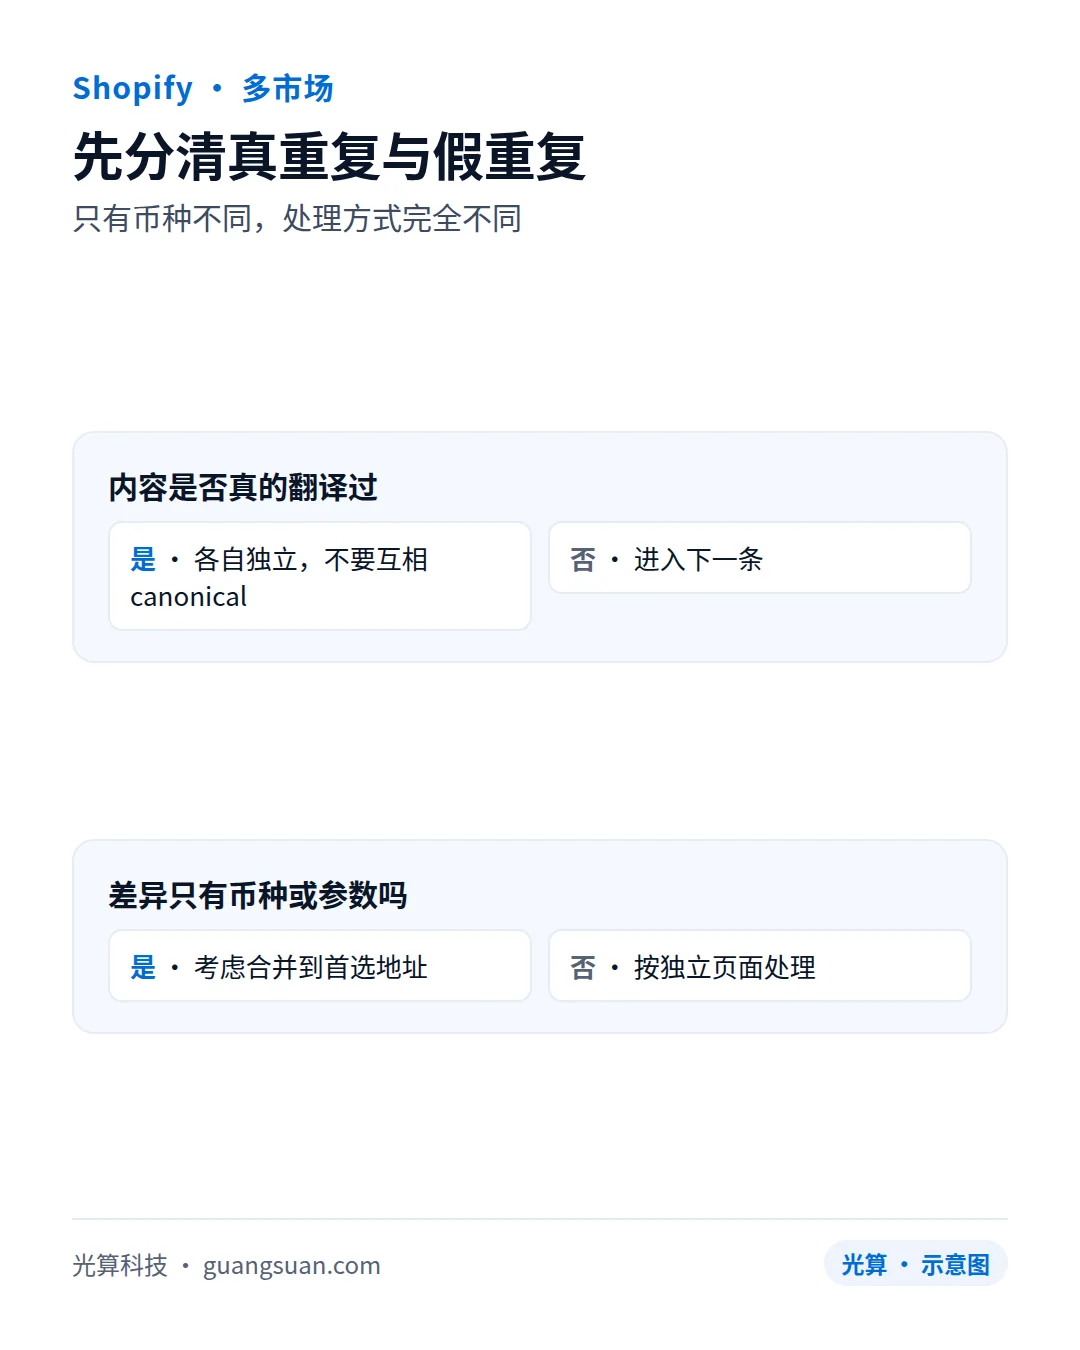
只有币种不同,处理方式完全不同(光算 · 示意图)
还有一类同语言内部的重复跟翻译无关,却更容易被漏掉:同一件产品在站内存在两条可以访问的路径,比如集合路径里的产品和独立产品页,两者都能打开、内容一致。这种重复不来自语言设置,来自主题渲染,判定方法在 同一件产品出现两种路径时先查主题里的 within 里讲过。多语言站一旦叠上这种情况,canonical 就会开始互相打架,所以先把它清掉再谈语言。
真翻译过的页面,canonical 要写自己
确定一个页面属于真翻译之后,规则很简单:每个语言版本都 canonical 到自己,同时把所有版本通过 hreflang 互相指全。Google 对 hreflang 的要求 里有一条硬规则,每个语言版本必须列出包括自己在内的全部版本;互指缺一处,整套标注就可能不被处理。
不要把所有语言版本 canonical 到主语言。按 规范化的说明,Google 会拿 canonical 页作为评估内容和质量的主要来源,搜索结果通常也指向它。把所有版本指向英文页,等于告诉 Google 这几页只需要保留英文那一版,翻译好的页面在评估阶段就被换掉了。
操作上要留意翻译内容存在哪一层。原文和译文通常是两套记录,改原文之后译文不会自动跟着变好,需要按字段核对,尤其是描述里的规格、单位、材质这些位置。核对时不要只看页面上有没有字,要拿原文和译文逐句比一遍,机翻留下的痕迹往往就藏在这些字段里。装或换翻译方案之后,某些实现还会把 canonical 改回原文 URL,页面看起来是翻译的,信号却指向原文;换过插件或主题之后重抽一次源码,是我见过的性价比最高的一次检查。
这条规则也有它的边界。canonical 是提示不是规则,Google 会综合协议、重定向、sitemap 等信号自己挑代表 URL,你标哪一版它都有权不采纳。意思是标得对不保证一定生效,标错却一定会提高被误判的概率。
半翻译的页面先别急着上线
只翻译了按钮和页脚的站点,那些语言页面对用户没有增量价值。它们既解决不了本地读者看不懂产品描述的问题,又给 Google 送了一批内容相同的 URL,还占用抓取。现实一点的做法是先挑重点:首页、主要集合页、卖得最好的产品页、几篇有搜索需求的博客,把这几类的正文翻完再发布对应语言;其余的页面留在原文,或者干脆先不上线。
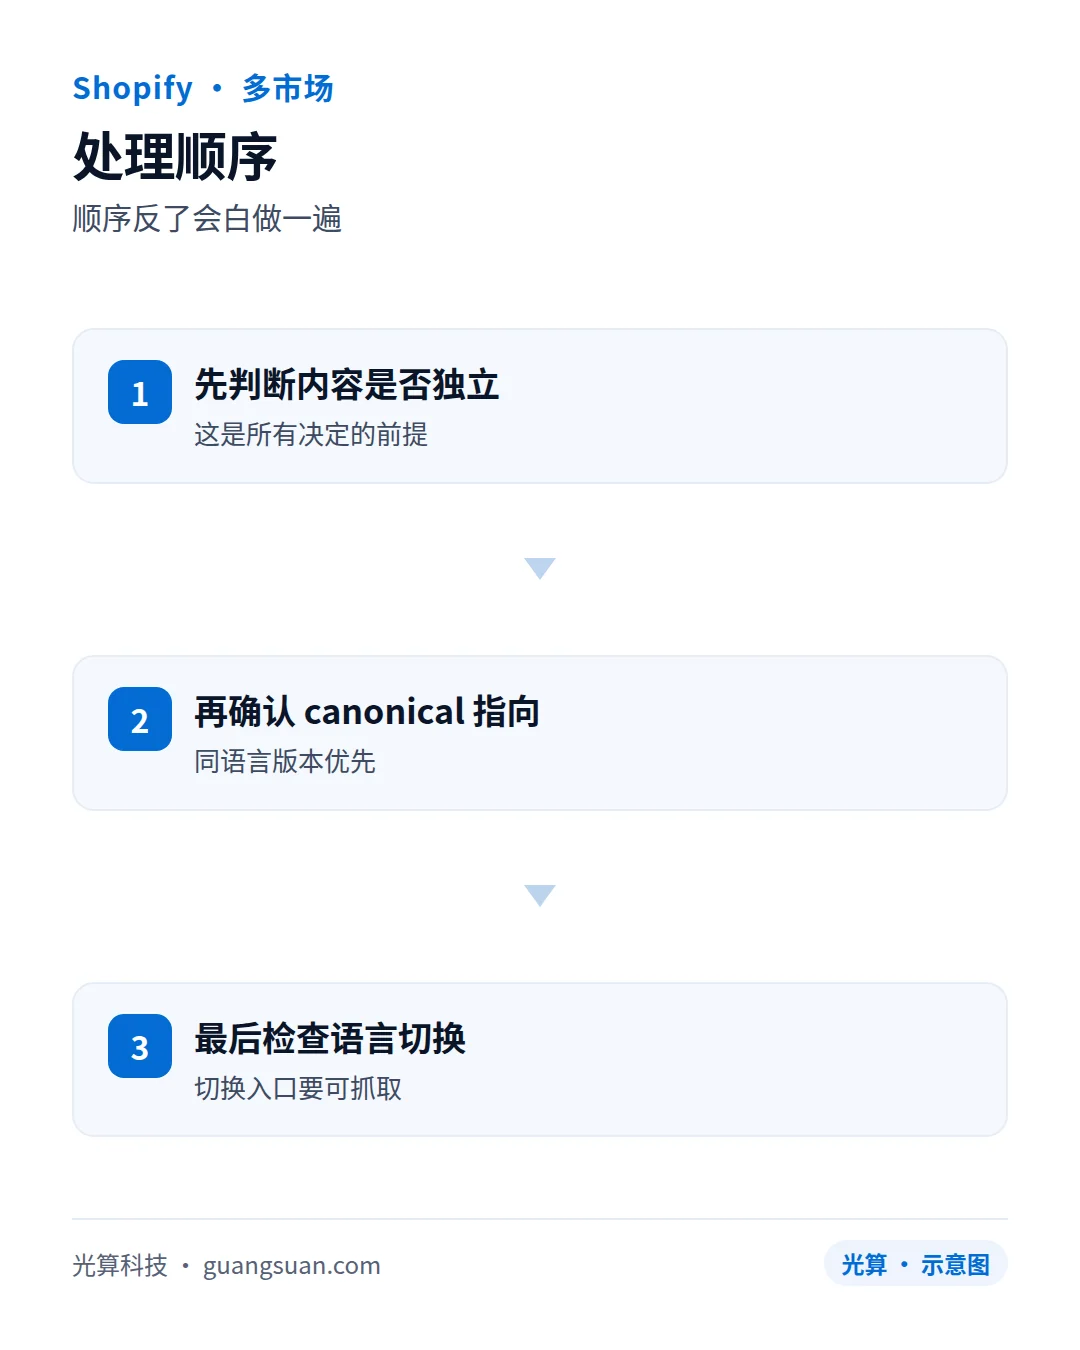
顺序反了会白做一遍(光算 · 示意图)
这样做不会因为版本不全而失效。Google 明确说明,如果维护完整互指太困难,可以只让部分语言互相指,它会处理那些彼此指全的部分;但新扩展的语言页必须和原有的主力语言互指。翻译方案的选型可以参照 翻译插件与原生 Translate & Adapt 的对比,那里按内容可控性、数据同步和前台成本三个维度做了取舍。
集合页和博客页是最容易失控的地方
产品页通常有固定的字段结构,翻译起来还有秩序;集合页和博客不一样,它们的正文是运营随手写的,谁都改过一点,翻译任务派下去的时候经常漏掉一半。结果是产品页有三种语言,集合页只有两种,博客只有一种。这种半覆盖的站点最难维护,因为 hreflang 的集合要在每个页面上保持一致,只要有一个页面缺了某个语言版本,那套标注就得单独处理。
做法上可以定一个下限:新语言上线时,首页、主要集合、主力产品、公司介绍和一个联系方式页面必须齐全,其他内容按季度补。集合页与博客正文本身值不值得翻,判断标准和单语言站一样,是搜索需求和转化价值,不是语言数量。这几类页面的正文结构怎么安排,另外有文章专门讲;这里只强调一点,翻译任务的清单要按 URL 列,不要按页面类型估。
语言切换器要留下能被抓到的链接
切换器是这类问题里最容易被忽略的一环,因为它在浏览器里用起来完全正常。按 Google 对 JavaScript 的处理说明,它接受用 JavaScript 往页面里注入链接,条件是这些链接要符合可抓取链接的最佳实践;而 robots.txt 拦掉的页面,Google 根本不会渲染上面的脚本,切换器自然也就等于不存在。这两种情况在界面上看不出区别,只有看渲染后的源码才能发现。
几个常见的实现问题。第一,切换器是用按钮加脚本改地址栏,HTML 里没有真实的链接,抓取器拿不到语言版本之间的连接关系。第二,切换逻辑带 cookie,用户上次选了德语,这次打开英文页先返回英文 HTML 再由脚本跳到德语,抓取器看到的和用户看到的不一定是同一版。第三,切换器里的链接指向目标语言的首页,而不是当前页面对应的语言版本,用户切一次就被踢回首页,只能重新找产品。前两个影响识别,第三个直接影响转化,改起来也最简单。Shopify 的导航可以在后台按菜单管理并指定显示位置,把语言入口做成菜单项是可维护的做法。
按这个顺序查,一次只改一层
- 抽五个核心页面:首页、一个集合、一个产品、一篇博客、一个静态页,把它们的全部语言版本 URL 列成表格。
- 逐页查看渲染后的源码,记录三样东西:canonical 指向谁、hreflang 集合是否完整且含自身、各版本是否互指。
- 判断正文有没有真的翻译。随机抽产品描述、集合描述、博客正文各一段来看,只翻译了按钮和页脚的直接归入半翻译。
- 检查切换器的 HTML 里有没有真实链接,链接指向的是对应语言版本还是首页;把 JavaScript 关掉再看一次是否还能切换。
- 翻 Search Console 里已被索引的 URL 清单,挑出带参数的重复版本,标出哪些属于必须保留的购买路径。
- 按顺序修复:先补正文,再统一 canonical,最后处理切换器和参数。改完重抽一次源码复核,不要一次改三项然后猜是哪项起了作用。
修复顺序这一步别贪快。同一批页面里既有结构问题又有内容问题的,先动内容;内容和结构同时改,出问题时你会分不清是标注改对了还是内容刚好补上了。另外要提醒一点,下面这些动作最好在主题的预览环境里先做一遍,确认语言切换、加购、结账这条主路径没有被打断,再去改线上的模板。
参数和币种那部分单独有一套判断标准,比 canonical 更纠结,写在 币种与价格展示的处理方式 里;多语言 URL 形态本身由 Markets 的设置决定,前置规则在 Markets 与 hreflang 的 URL 对齐 那一篇。参数型 URL 要不要被索引,还有一层和站内搜索页相同的判断逻辑,可以对照 筛选 URL 与站内搜索页的索引判断。
这些事做不到,也没必要慌
- 重复内容本身不违反 Google 的垃圾内容政策,文档里写得很清楚。它的实际代价是让用户分不清哪个页面才对,也让你更难判断内容在搜索里的真实表现,属于该修但不该恐慌的一类。
- canonical 和 hreflang 都是提示。标注正确不代表 Google 一定采纳,标注缺失也不代表版本一定不被合并,只能通过抽源码和看后台的实际情况来确认。
- Shopify 前台渲染出什么 canonical 与语言标注,取决于主题、设置和装过的应用,官方帮助文档没有逐项承诺,任何结论都要以你自己站上抓到的源码为准。
- 收录时间没有承诺。按 Shopify 的 sitemap 文档,抓取和索引需要时间,Google 不保证需要多久。
如果该标的都标了、翻译也补齐了,对应的语言版本长期没有出现在搜索结果里,那已经从重复内容问题变成抓取与收录问题,方向完全不同,可以看我们做 谷歌收录 时的排查思路。