
筛选页和站内搜索结果页要不要进索引,没有统一答案,但判断顺序是统一的:先问有没有人这样搜,再问这页的内容是不是唯一的,最后问它有没有稳定的站内入口。三条都成立才值得让它进索引,只要有一条不成立,就该考虑合并、指定规范地址或者不索引。顺序反过来做,先动代码加标记,最常见的后果是把本来有流量的筛选页一起处理掉了。
第一问:真的有人这样搜吗
拿筛选组合去做验证之前,先想买家会不会这样输入。他们会输入"手摇咖啡磨 便携",未必会输入颜色加容量再加排序方式。后者是屏幕上的控件状态,不是人的说法。可用的验证渠道有三个:搜索框的建议词、站内搜索日志、客服被反复问到的问题。
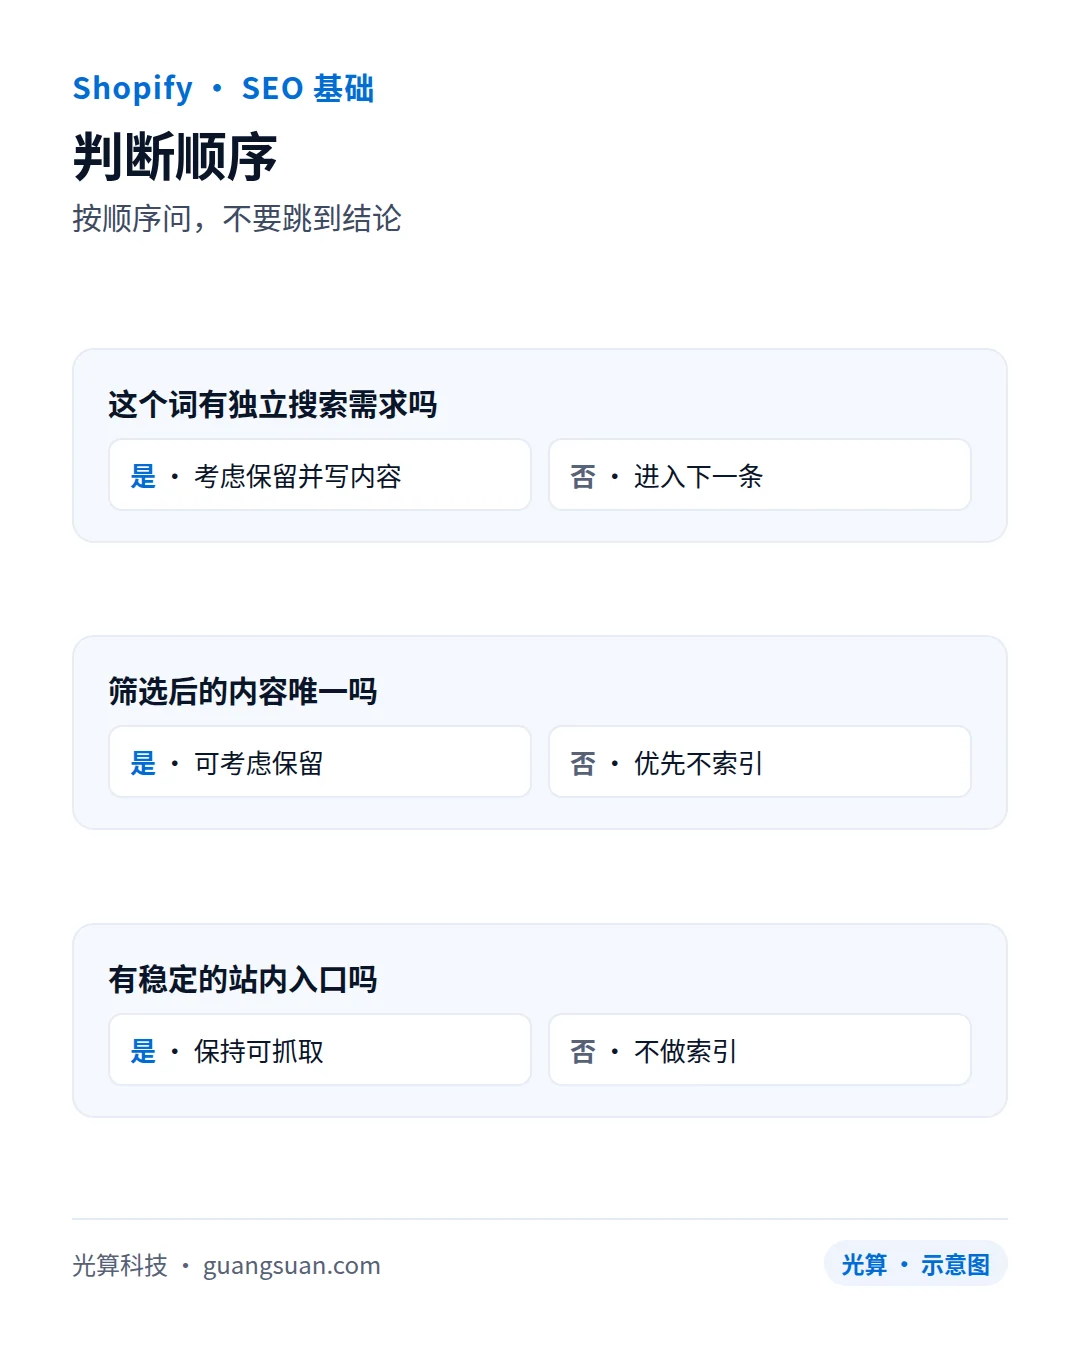
按顺序问,不要跳到结论(光算 · 示意图)
还有一个操作层面的细节常被跳过:站内搜索日志里的高频词,往往就是该做成独立集合页或文章的选题。把它们整理成一个月度清单,比上新前临时决定筛选条件靠谱。这份清单同时是判断"某个筛选组合有没有独立价值"的证据,能避免凭感觉给页面加索引。
没有数据的时候,把判断标成编辑判断,别当成结论。多数店铺真正有搜索需求的筛选组合只有少数几个,比如"户外用的型号"或者"不锈钢款式"。这几个值得有独立页面和固定入口,其余大多数组合没有这个待遇。
第二问:内容是不是唯一的
筛选页最容易出问题的地方就是内容重复:不同参数组合下,商品列表只差几个条目,标题和描述几乎一样。Google 在规范化说明里把分类页的排序与筛选功能直接列为产生重复内容的原因之一,并说明同一内容能通过多个地址访问会让用户困惑,也让效果追踪变难;同一段说明还强调,你自己写的规范链接只是提示,最终挑哪一页由 Google 判断(Google 关于规范化的说明)。
由此得到一个实际取舍:两个组合如果只有排序不同,分别指定规范链接没有意义,应该都指向不带参数的基础集合页;页面内容真的换了另一批商品时,规范链接指向它自己。同类判断在商品地址上出现过,同一产品出现两种路径时先查主题里的 within 讲的是同一个逻辑。
第三问:有没有稳定的站内入口
没有任何页面链接过去的地址,只能靠 sitemap 和历史链接被发现,价值有限。这里的判断标准也很直接:运营愿不愿意在导航或集合页正文里给它一个固定链接。愿意,说明它值得进索引;不愿意,就只剩参数组合被碰巧抓到这一条路,那种页面通常只消耗抓取,不带访问。有价值的筛选组合该做成独立集合页而不是参数地址,集合页怎么安排标题、描述与正文,见集合页 SEO 的标题、描述与正文安排。
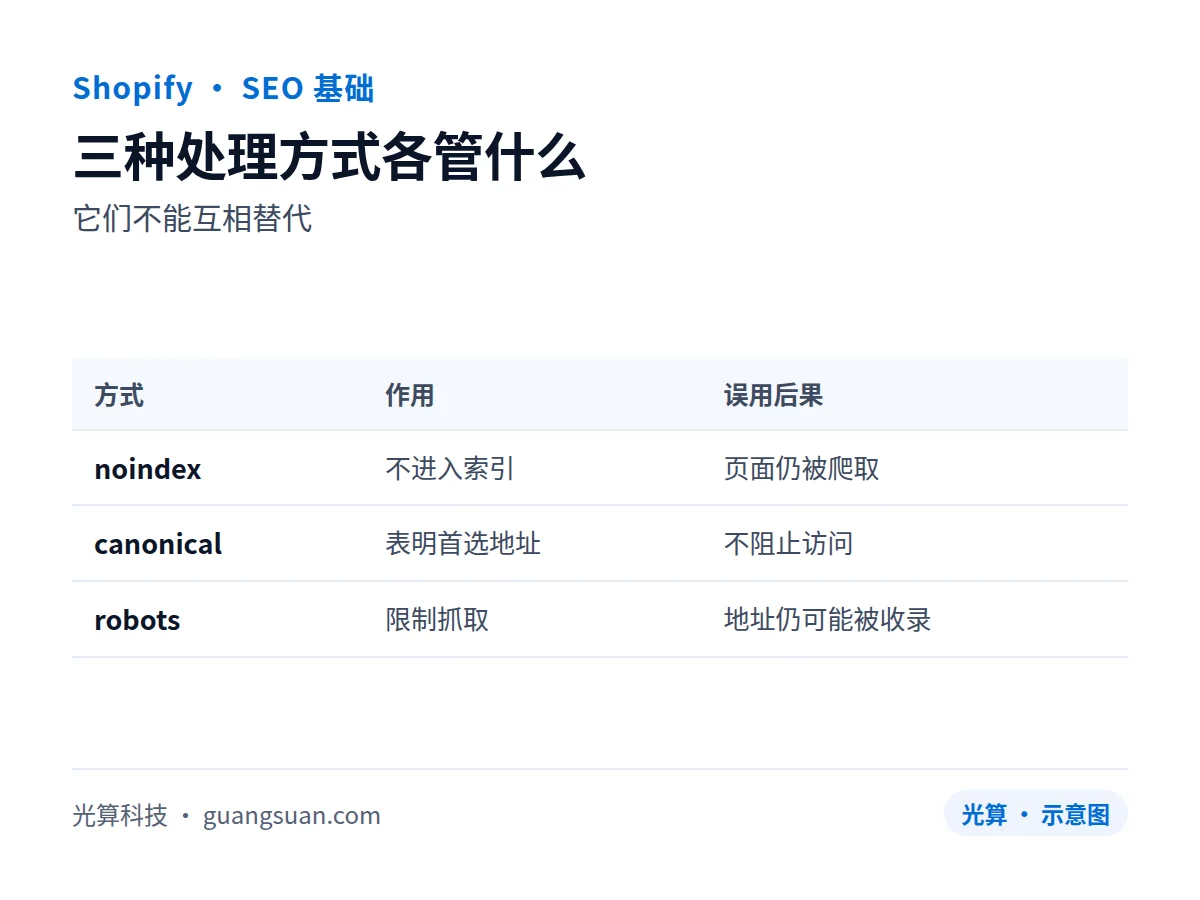
它们不能互相替代(光算 · 示意图)
站内搜索结果页:默认就不该被索引
搜索页的内容由访客输入的关键词生成,参数可以任意组合,页面数量没有上限,也没有稳定入口。让这类页面进索引,等于把一批内容重复、随时变化、没人维护的地址交给搜索引擎。做法上只有一个选择:不索引,但保留可抓取。
还有一类页面的性质与站内搜索接近:账户页、订单查询、购物车、结账流程。它们通常不需要专门处理,要么要求登录,要么处在一次性的流程里,是否输出了索引标记用网址检查工具看一眼就能确认。真正需要你动手的,是主题和应用额外生成的那些列表地址——它们不在平台默认的可索引范围里,却常常被当成正常页面抓走。
顺带说清一个常见误操作:不要用 robots.txt 去挡站内搜索页。Google 的说明写得很清楚,robots.txt 是管理抓取流量、避免服务器被请求压垮的手段,不是把页面挡在 Google 之外的机制;被它挡住的地址依然可能出现在结果里,只是没有描述,而且爬虫根本不去抓取,也就读不到页面上的 noindex 标记(robots.txt 说明)。两个手段叠在一起用,结果是两个都不生效。
给搜索模板加 noindex 的具体做法
主题里搜索页有对应的模板。用 Liquid 模板的主题,可以在模板输出的 head 部分加条件判断:
{%- if template.name == 'search' -%}
  <meta name="robots" content="noindex, follow">
{%- endif -%}
主题用的是 JSON 模板时,模板文件本身放不下这段代码,因为 JSON 模板里的 HTML 与 Liquid 必须写在被引用的 section 内(见 Shopify 主题模板文档)。这种情况下更稳的位置是布局文件里的 theme.liquid,用同样的条件判断统一输出。robots meta 标签要输出在 head 里,位置放错等于没写,Google 对这类标签的用法有单独说明(JavaScript 与搜索基础)。
验证分三步:打开搜索页地址查看源码,确认 head 里出现了这段标记;用网址检查工具确认 Google 看到的结果也是不索引;过几天再回 Search Console 看该地址的收录状态有没有变化。改动前后各留一份源码文本,日后才说得清改了什么。
为什么是"保留可抓取"
不索引和不让抓取是两件不同的事,搜索页要做的是前者。用 noindex 时页面照样被抓取,抓取过程会继续发现页面上的站内链接,站内其他页面不会因此失去入口。如果反过来把抓取也挡掉,爬虫不进这个地址,也就读不到 noindex 标记,一旦有别的站点链接过来,这个地址仍可能以没有描述的形态出现在结果里。这也是为什么处理这类页面的顺序是"先标记、后观察",而不是"一刀切屏蔽"。
分页和参数一起出现时,先处理哪个
文章列表、集合列表翻到第二页第三页,通常也是由参数生成的地址。这类地址和筛选参数不一样:它们的内容是接续的,不是重复的,而且爬虫需要沿着分页往下走才能发现列表深处的商品。所以分页的处理方式是不加 noindex,让它可以被抓取,同时不必主动写进内链之外的任何地方;真正需要收敛的是参数组合,尤其是没有独立价值的排序和多值筛选。
两者混在一起时按这个顺序做:先给搜索页加 noindex,再收敛筛选参数地址,最后检查分页是否可以正常抓取。顺序反了容易误伤——先给分页加 noindex,列表深处的商品可能迟迟不进入抓取范围,而这类损失在报告里很难直接看到。
筛选参数该怎么处理
| 参数类型 | 要不要进索引 | 处理方式 |
|---|---|---|
| 站内搜索关键词 | 不要 | 搜索模板加 noindex,保留抓取 |
| 排序参数 | 不要单独进 | 规范地址指向基础集合页 |
| 单一筛选值且有搜索需求 | 要,但别靠参数地址 | 做成独立集合页并给固定入口 |
| 多值组合筛选 | 不要 | 不写入静态链接,随交互生成 |
最后一行最容易被忽略。组合筛选的可点击链接如果由脚本生成,爬虫不会把它当作新的抓取目标;反过来,主题把每个组合都渲染成静态链接,抓取量会成倍上升,而能带来访问的只有极少数组合。排序与筛选的状态保存是否正常,是主题交互层面的活,排查思路见一排序就丢筛选时的 URL 状态排查。组合筛选靠脚本实时重排商品列表时还会牵到交互延迟,这一项单独属于交互延迟与主线程的范围。
抓取预算:减少无价值地址比屏蔽更有效
规范化说明里提到,被选中的规范版本会被更频繁地抓取,重复版本抓取频率更低,目的是减少对站点的请求压力。也就是说搜索引擎自己会做取舍,但它依据的是页面质量与唯一性,不是你希望它抓哪一个。站内能做的三件事:把参数地址从链接里减掉,把有搜索价值的筛选组合做成真正的集合页,别让参数地址进 sitemap。
这里要泼一点冷水:抓取预算这个概念在小站上经常被滥用。几百个产品的店铺,URL 总量可能只有几百到几千条,先纠结抓取预算,不如把产品描述和图片做好。只有当参数页面数量明显超出实际需要时,收缩地址才有可衡量的收益。类似地,币种与比价参数造成的地址膨胀是另一个议题,处理方式见币种与价格参数造成的重复地址。
五个常见误操作
- 用 robots.txt 挡站内搜索页,以为屏蔽抓取等于不让收录;
- 给参数地址加了 noindex,站内却仍然保留指向这些组合的静态链接,抓取量没有下降,真正变化的是这些页面的收录状态;
- 把有价值的筛选组合做成纯脚本交互,没有可抓取的链接,却指望它出现在搜索结果里;
- 给搜索页指定规范地址指向首页,把两个不同类型的页面混成一个;
- 改完之后只看代码,不回搜索结果和报告里看实际变化。
改完之后的核验清单
- 搜索页与参数地址的源码里,robots 标记是否符合预期;
- 站内链接里还有没有指向参数组合的静态链接;
- sitemap 里有没有混进参数地址,排查顺序见sitemap 三层子表的结构与常见报错;
- 有搜索价值的筛选组合是否已有独立页面与导航入口;
- robots.txt 里有没有为了图省事添加的 Disallow,改法的边界见Shopify 的 robots.txt 能改哪部分;
- 一个月后对比参数地址的抓取与收录数量变化,别只看前一天的结果。
整站层面,这类活有个固定顺序:先解决"该收录的没收录",再处理"不该收录的却被收录了"。前者直接影响收入,后者影响效率。哪些页面该被收录却迟迟没进索引,属于谷歌收录工作里最先要做的判断。