技术 SEO 与抓取索引
共 141 篇文章 · 第 3 / 15 页
-
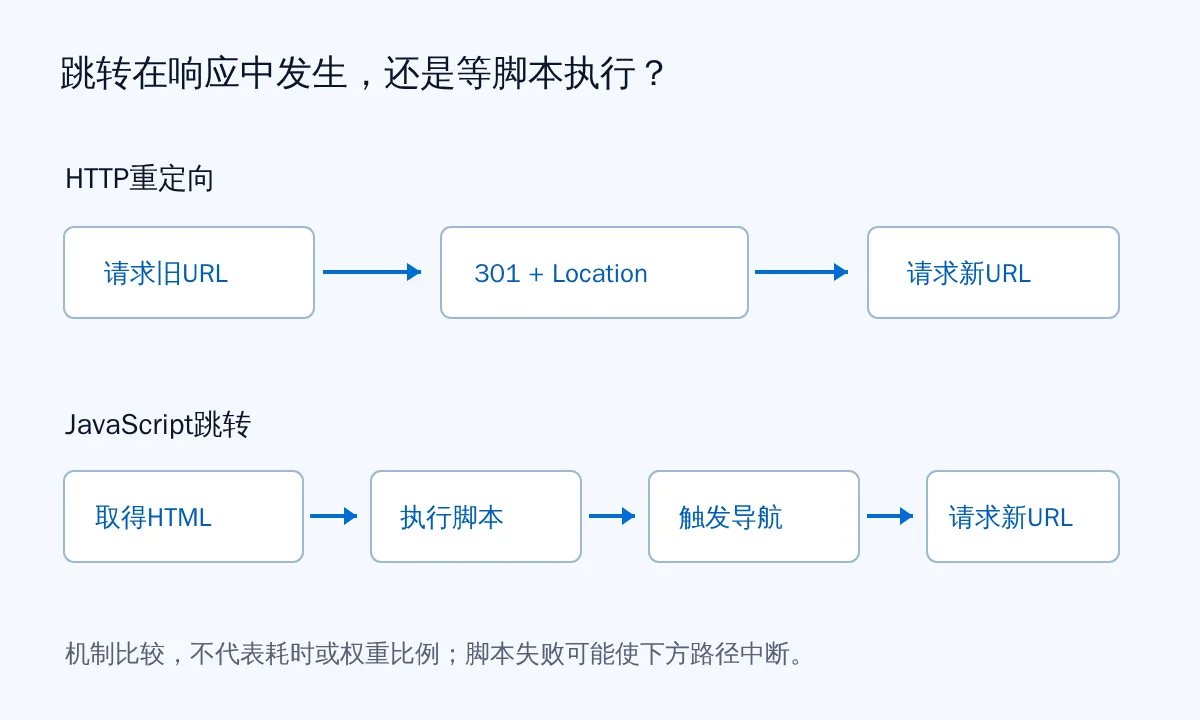
JavaScript跳转能代替301吗?按迁移目的选对重定向
JavaScript跳转不等于HTTP 301。按永久或临时迁移目的选择方式,核对首跳状态、Location、目标内容和内链,避免把前端切页当作服务器重定向。
-
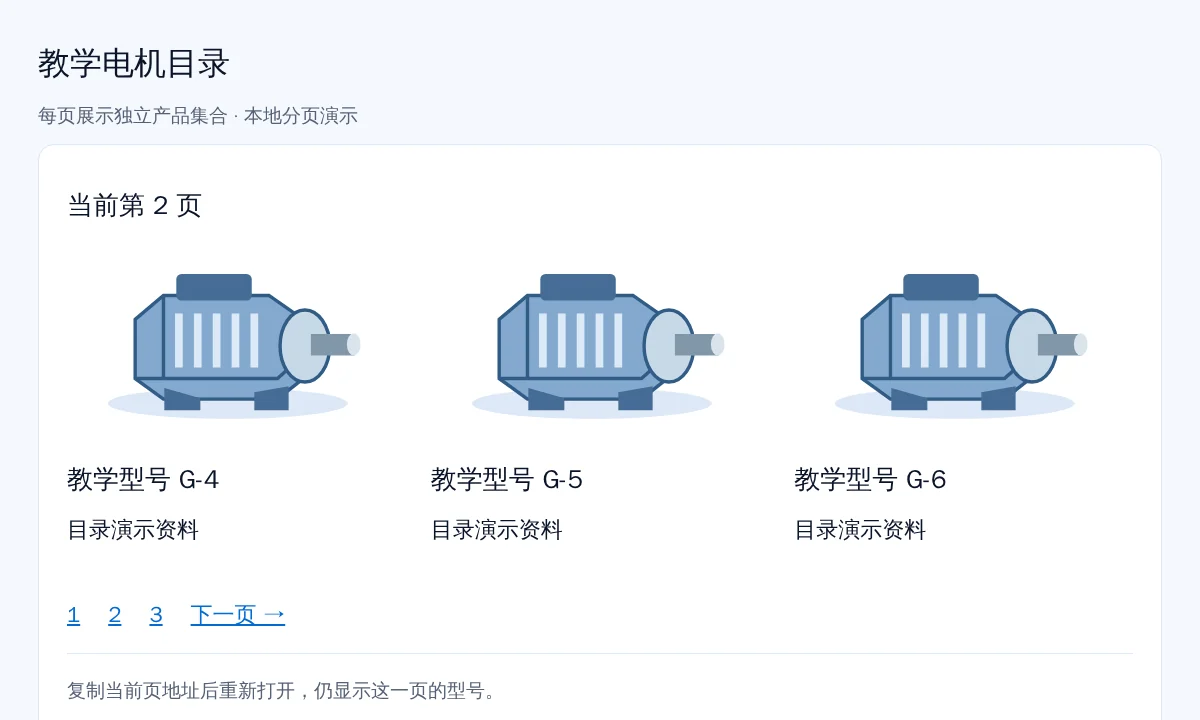
分页canonical全指第一页?产品目录模板要这样改
第二页不是第一页副本。核对独立产品集合、自指canonical、标准页间链接、异常页码与客户端覆盖,修复分页模板而不无差别开放筛选URL。
-
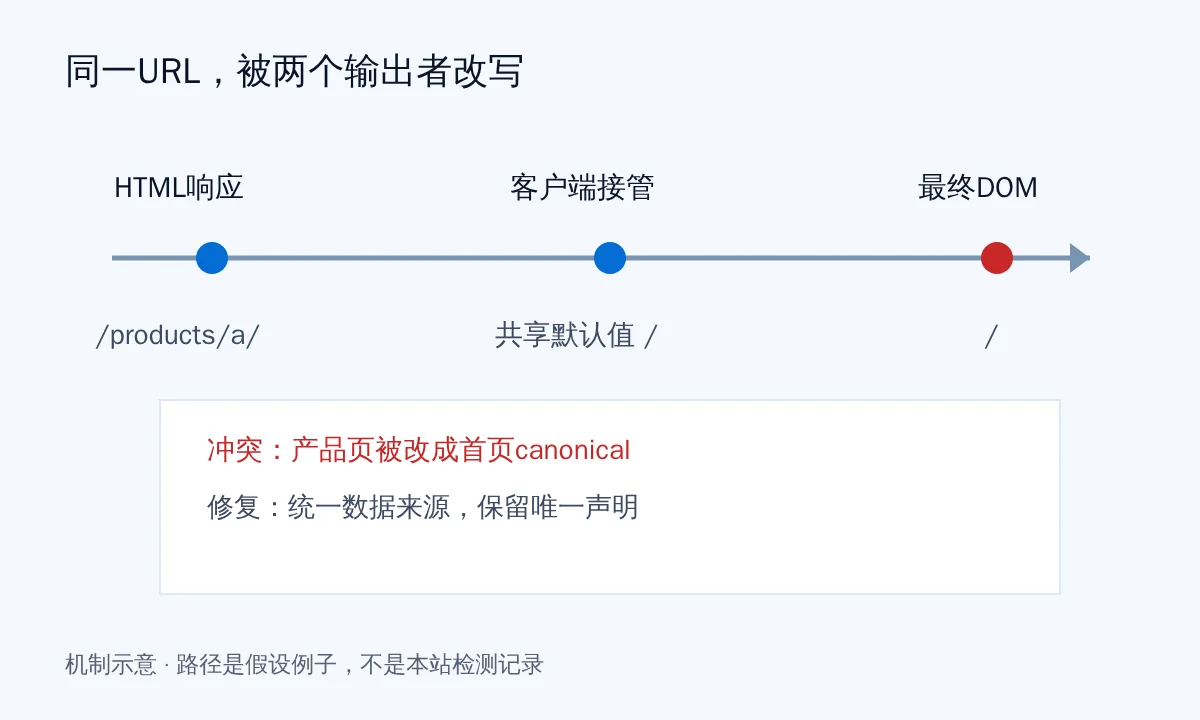
页面加载后canonical变了:排查SSR与hydration的URL冲突
原始HTML的canonical正确,客户端仍可能改错。按直接访问、渲染完成与SPA切页记录规范网址,定位共享默认值、重复输出和路由规则冲突。
-
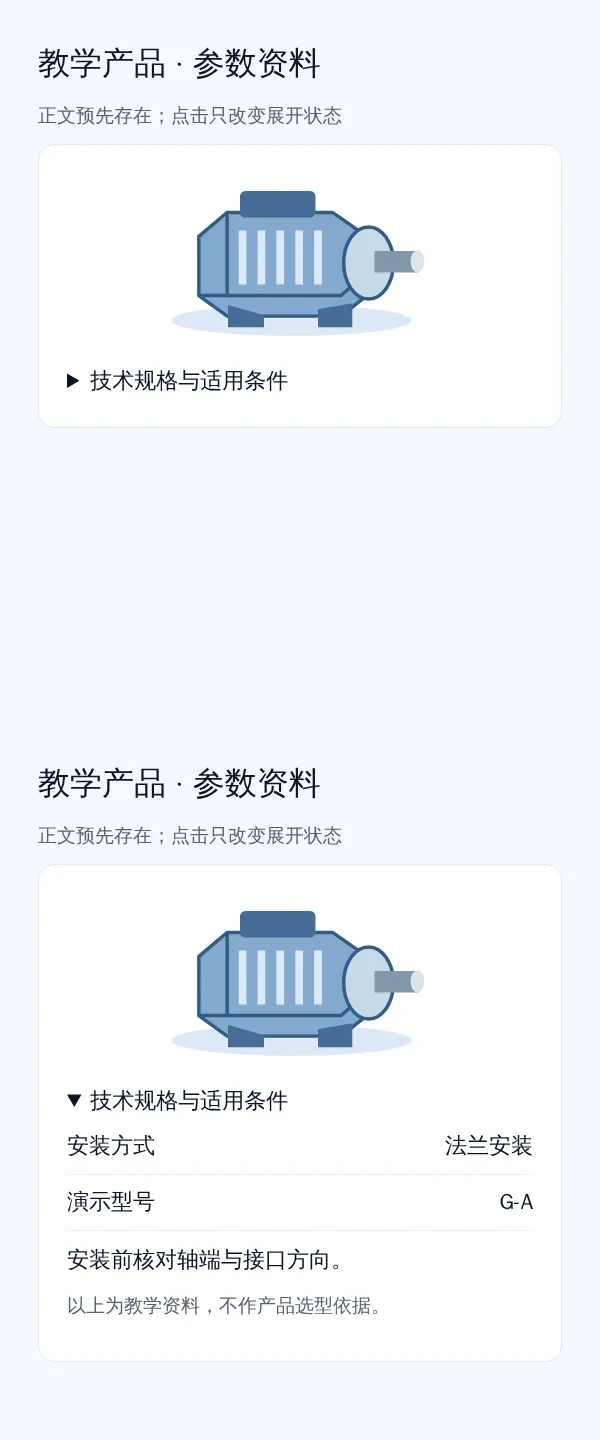
产品参数放折叠标签页,会影响SEO吗?关键看数据何时加载
参数折叠不必一律取消。区分预先交付的正文与点击后才取数的面板,检查手机内容、参数条件和交互可读性,让采购者能找到完整规格。
-
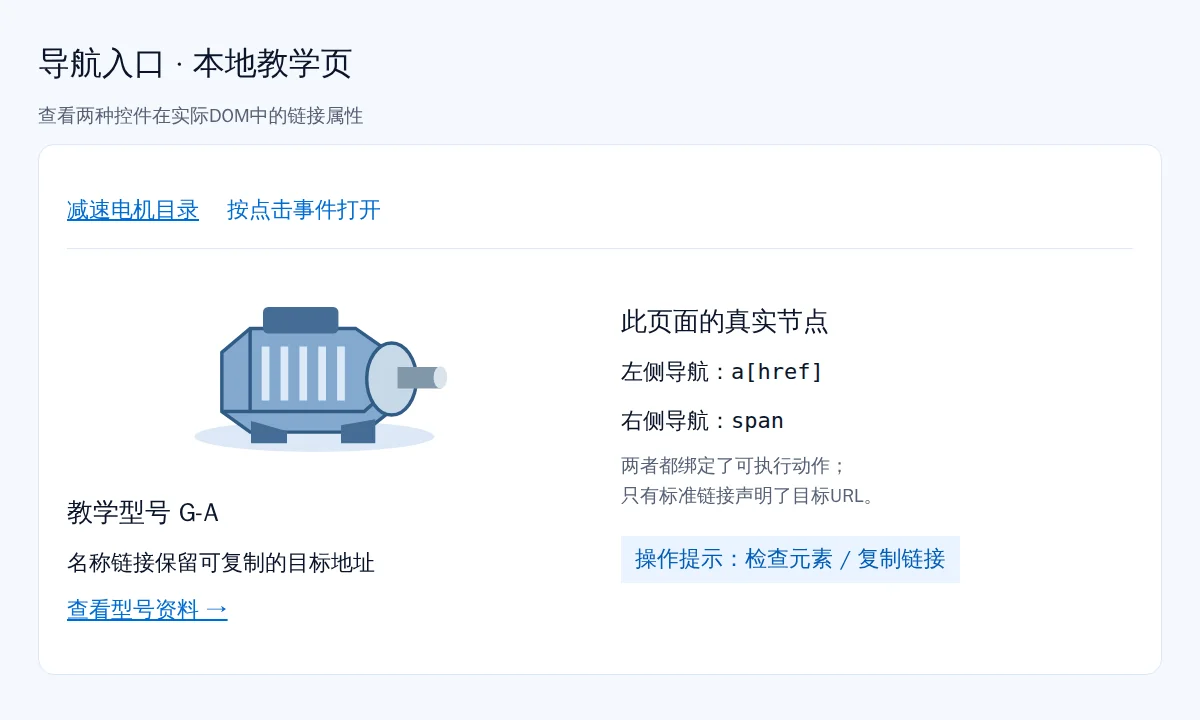
菜单点得开,谷歌却未必找得到:onclick导航怎样补上真实链接
菜单能点开不等于可抓取。用实际DOM、真实href、目标页直达与手机导航检查,修复onclick入口,同时保留前端路由和正常浏览器操作。
-
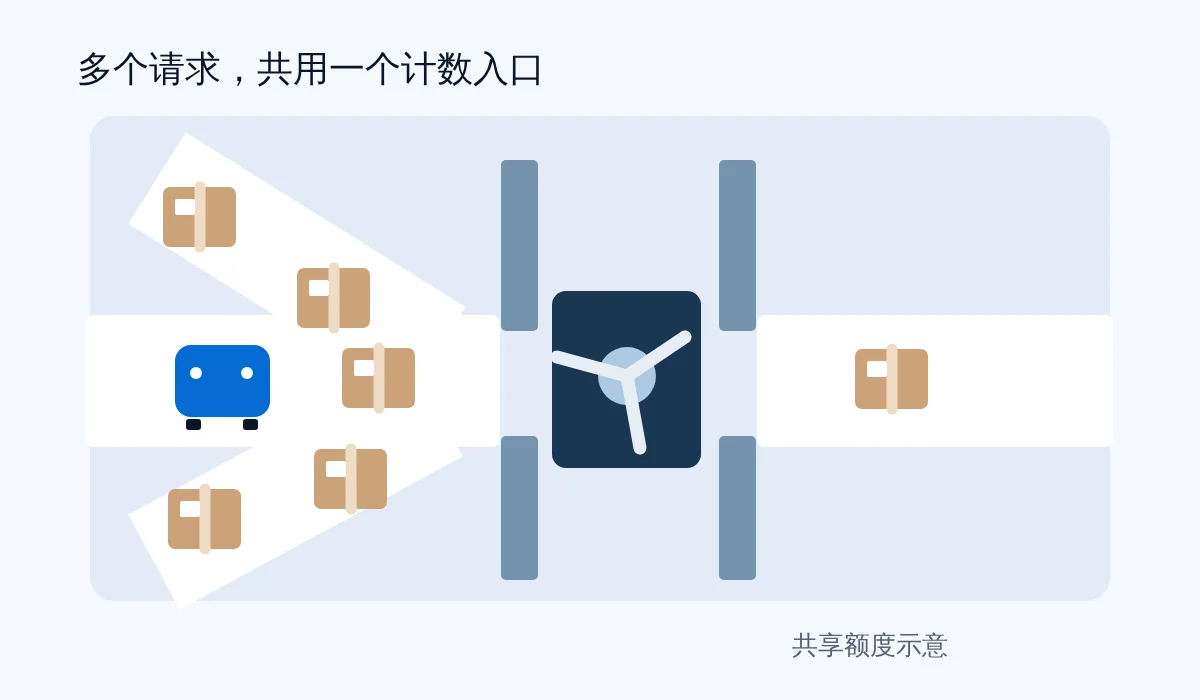
Googlebot遇到429后怎么恢复?限流规则先查计数对象
Googlebot收到429,先查限流规则按谁计数。区分共享代理IP、资源突发和真实过载,核验爬虫身份后有限调整,并说明Retry-After、临时规则撤销及抓取渐进恢复的边界。
-
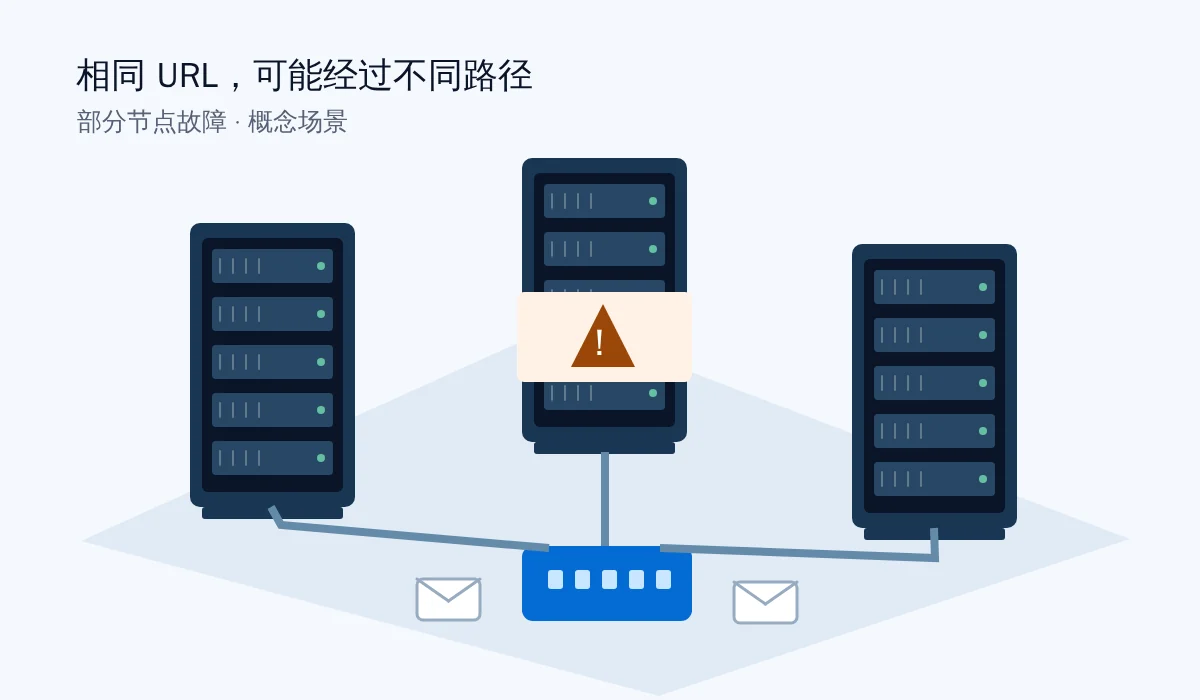
偶发502、504也要修吗?按URL和时间找出抓取不稳定的来源
偶发502、504不能只靠刷新判断已修复。本文按URL、时间、缓存与上游请求ID定位间歇5xx,说明Google处理服务器错误的方式,以及原故障条件下的持续恢复检查。
-
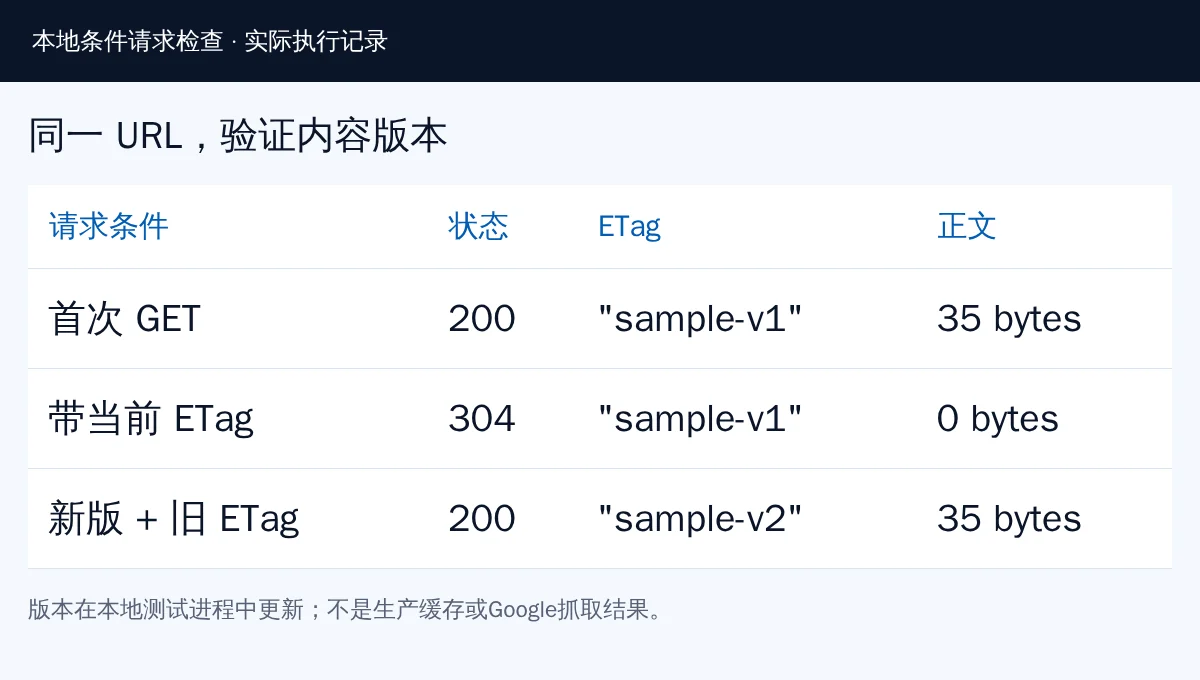
304不是抓取失败:怎样验证ETag没有把新版页面挡在外面
304通常是正确复用缓存,不是抓取失败。用首次GET、匹配ETag和内容更新后的旧ETag做对照,检查条件头优先级、弱验证器及正文版本,避免把新版页面误判为未修改。
-
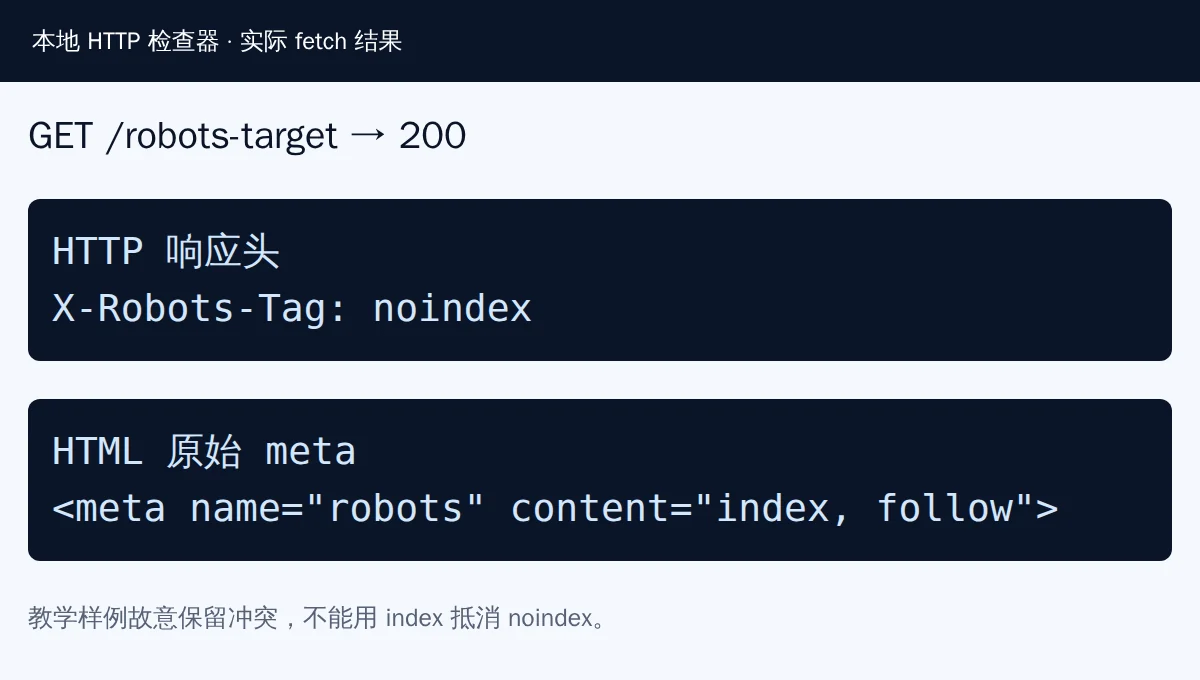
HTML写了index,响应头却有noindex:robots冲突听谁的
HTML的index不能抵消适用的X-Robots-Tag noindex。按Google更严格规则原则,检查通用与定向指令、多个响应头和输出层,分清抓取、索引、摘要限制及正文代码示例。
-
网站短时维护用503还是200?Retry-After与恢复检查要一起做
短时维护用503表达暂时不可用,Retry-After只提供重试提示。了解何时保留公开内容、为什么不用200或noindex替代、robots.txt如何处理,以及恢复正文与清理维护缓存的步骤。