
Google 能收录 PDF,产品资料不必因为文件格式就全部重做。但对依靠询盘成交的外贸企业,只有一本目录,买家往往还得自己找型号、核对适用条件,再回官网寻找联系人。更合适的分工是:HTML 产品页承接选型和询价,PDF 保留完整规格、图纸与版本记录;是否让 PDF 单独参与搜索,要逐份判断。
PDF 谷歌收录:先确认文件内容能被读取
Google 的可索引文件类型文档明确列出 PDF。因此,“PDF 天生不被收录”不成立;支持这种格式,也不等于上传后一定收录,更不等于会排在 HTML 前面。检查产品目录 SEO 时,先拿到文件的直接网址,确认外部访问者能打开真实文件,而非登录页或下载错误页。
再复制一段型号和规格到纯文本编辑器,检查单位、上下标、表格列序是否丢失。这是资料可读性的初筛,不是 Google 收录测试。扫描版建议先做 OCR 并人工校对,尤其注意小数点、负号与型号中的相似字符。不要把搜索引擎可能识别图片文字,当作可以省略文字层的理由。
多语言目录还要检查下载标签与文件内容是否对应。英文产品页点开中文手册,并不会因为按钮写了 English 就解决阅读问题。没有完成对应语言资料时,应如实标注现有语言,保留可读的网页参数,而非复制一份文件改名充数。
文件名、文档标题与封面要能辨认产品系列和用途,别只留“final-new”。下载入口同时标明语言、版本和实际文件大小,方便买家决定是否下载。型号与单位使用目标市场熟悉的表达;文件名改得再漂亮,也无法补回漏掉的尺寸条件。
同一份规格资料,怎样拆给 HTML 和 PDF
从采购动作分,而不是按篇幅分。第一次接触供应商的人,需要知道哪些型号适合自己的工况、哪些条件会限制使用;准备技术确认的人,需要完整图纸、安装要求和可转发的固定版本。两种需求可以共享参数,没必要让两个载体逐字相同。
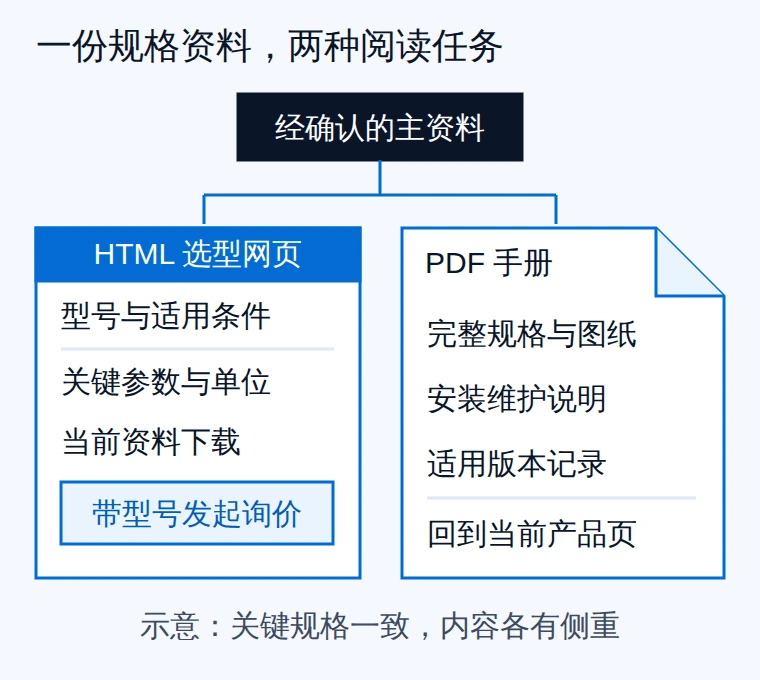
资料分工示意:网页保留选型所需信息,PDF 提供可下载、可追溯的完整版本。
以一组工业泵资料为教学示例,并非真实产品参数:HTML 先解释介质、流量和接口怎样影响选型,再用可见文字列出型号差异、单位及测试条件,给出对应手册下载和询价入口。PDF 则展开尺寸图、安装说明、维护要求与修订记录。网页不能只写“参数见附件”,也不必把维护手册整本搬上来。
两边的关键规格必须一致。建议由产品或工程负责人确认一份主资料,再同步网页与文档;如果数值取决于温度、负载或配置,限制条件也要一起同步。网页中的简化参数不能去掉前提,否则搜索带来的咨询越精准,销售解释矛盾的成本越高。
PDF 内放回对应产品页的完整网址,网页的下载锚文本写清系列和版本。买家把文件转发给同事后,接收者仍能找到当前信息。页面上的咨询按钮则应保留已选型号,避免从具体产品退回一个什么都没带的通用联系页。
让 PDF 收录、设 noindex,还是指定 canonical?
这三个选项解决的问题不同。不要给整个上传目录统一加规则,再期待所有手册恰好符合业务需求。
- 公开手册有独立的安装、维护或型号查询价值:可保留索引资格,同时做好版本和回站链接。
- 允许公开下载,但明确不希望文件出现在搜索结果:考虑在该 PDF 响应头设置 noindex。
- PDF 与网页内容重复或高度相似,希望合并规范版本:评估 canonical,不把它当成强制下架指令。
- 客户图纸、内部报价或保密技术材料:使用权限控制,不依靠搜索设置保密。
PDF 没有普通 HTML 的 head 区域。按 Google 的 noindex 文档,可以由提供文件的服务器返回 X-Robots-Tag: noindex。这段只是响应头示例,不是已验证的服务器配置。必须允许 Google 抓取文件,才能读到这个指令;同时用 robots.txt 封锁该 URL,可能使 noindex 无法被看到。规则也不会即时清除搜索结果,需等待重新抓取处理。
实施时让维护人员检查 PDF 最终下载地址的实际响应头,包括对象存储或 CDN 返回的内容;只检查产品页没有意义。规则应限定目标文件,避免误伤需要搜索曝光的其他资料。noindex 不阻止人直接下载,也不能保护已经转发出去的文档。
如果只是处理重复内容,Google 的 canonical 文档支持为非 HTML 文件使用 HTTP Link 响应头声明规范网址。它是规范化信号,最终选择仍由 Google 决定。几十页完整手册与一页简短介绍未必高度相似,不能只因属于同一产品就强行指定为同一份内容;也不要把 noindex 当作合并信号的替代办法。
目录换版时,别让老链接变成信息陷阱
建议保留稳定的产品页和下载说明入口,文件按可辨认的版本管理。新手册发布时,同步更新网页参数、下载链接、语言标签与修订说明。旧版仍服务已交付设备时,应清楚标注适用型号或批次,并指向当前资料;它是否继续参与搜索,需要结合旧型号支持需求决定。
不要把全部旧文件直接跳转到首页,也不要在接口或安全要求已变化时静默覆盖同名文件。买家手里的离线副本不会自动更新。对无法在线修改的旧 PDF,可通过仍可访问的下载说明页解释版本差异;今后导出的文件应自带版本和回站入口。
先改一组产品资料,检查到询价为止
选一个业务重点系列,列出网页、当前 PDF、历史版本及负责人。逐项核对规格,实际走完手机阅读、下载、返回产品页和发起询价的路径。后续在 Search Console 分开观察网页与 PDF 的查询表现;下载次数只说明资料被获取,不能直接算成有效询盘。
光算的谷歌 SEO 服务包含技术建议、内容建设与内链优化。对资料型网站,可先明确需要梳理的文件和产品页范围、参数确认责任及实施方式,再安排执行,不能把“有 PDF”直接诊断成排名差的原因。资料入口理顺后,继续检查RFQ 询价表单如何保留型号并确认提交成功,让买家不必在最后一步重新描述产品。